1. 认知基础:定义与演进
1.1 核心定义
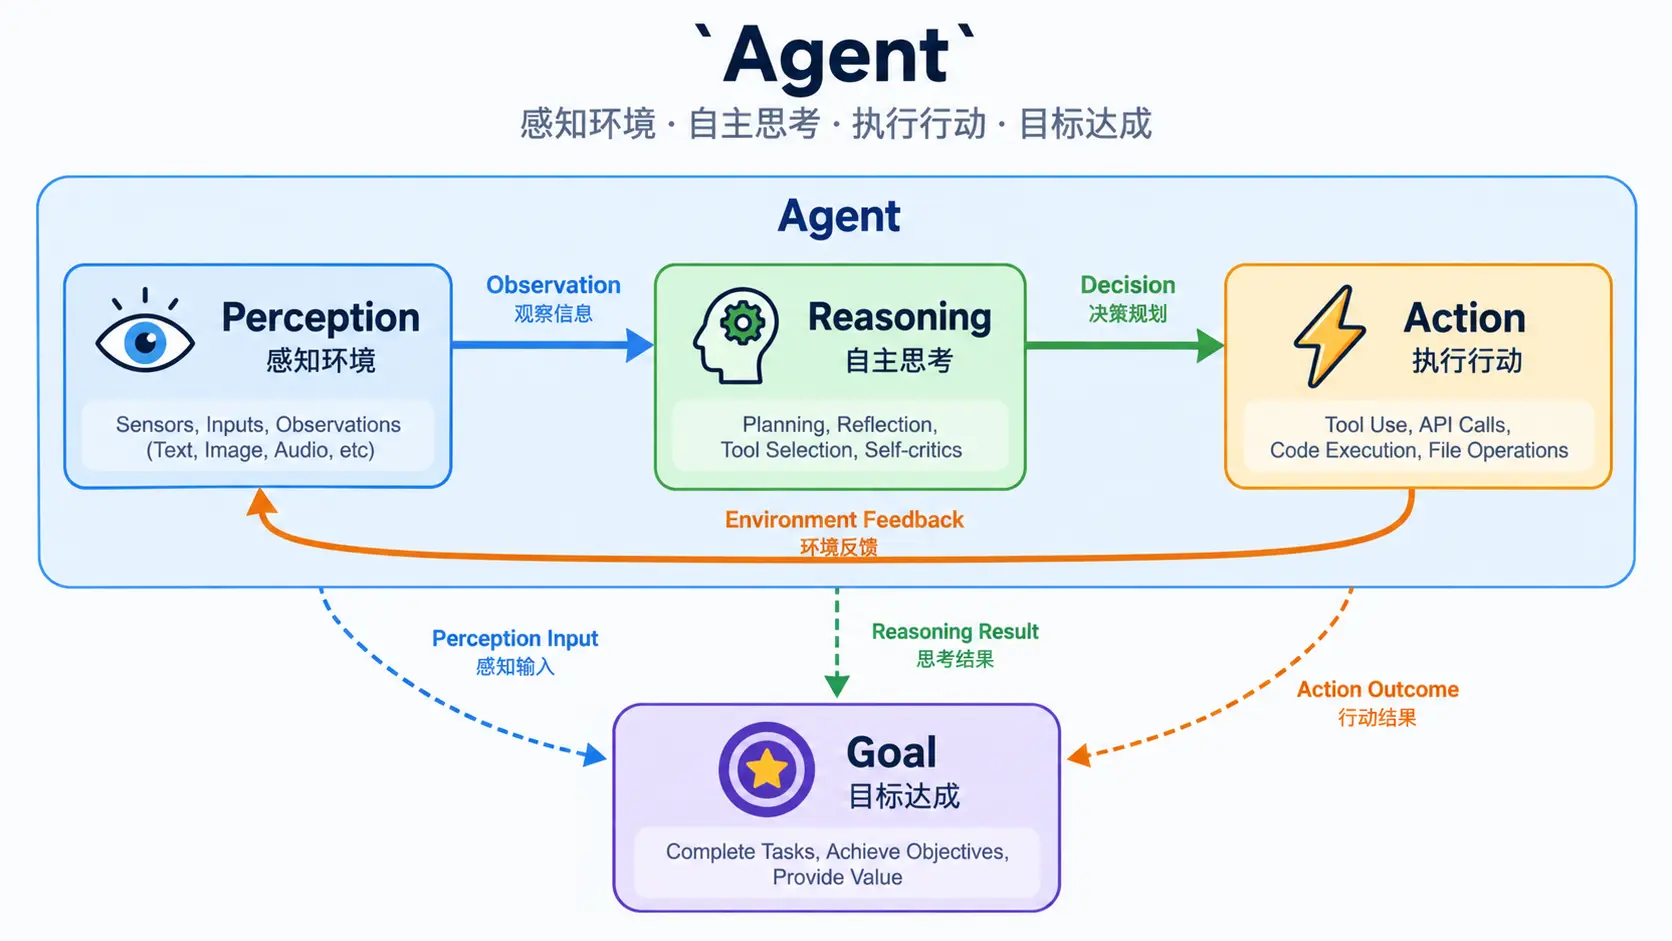
在 AI 领域,Agent 被定义为一个能够通过感知环境(Perception)-自主思考(Reasoning)-执行行动(Action)循环以实现目标达成的智能实体。
1.2 AI系统演进脉络
近几年,AI系统的发展主要经历了四个大的阶段。
ChatBot(对话机器人)
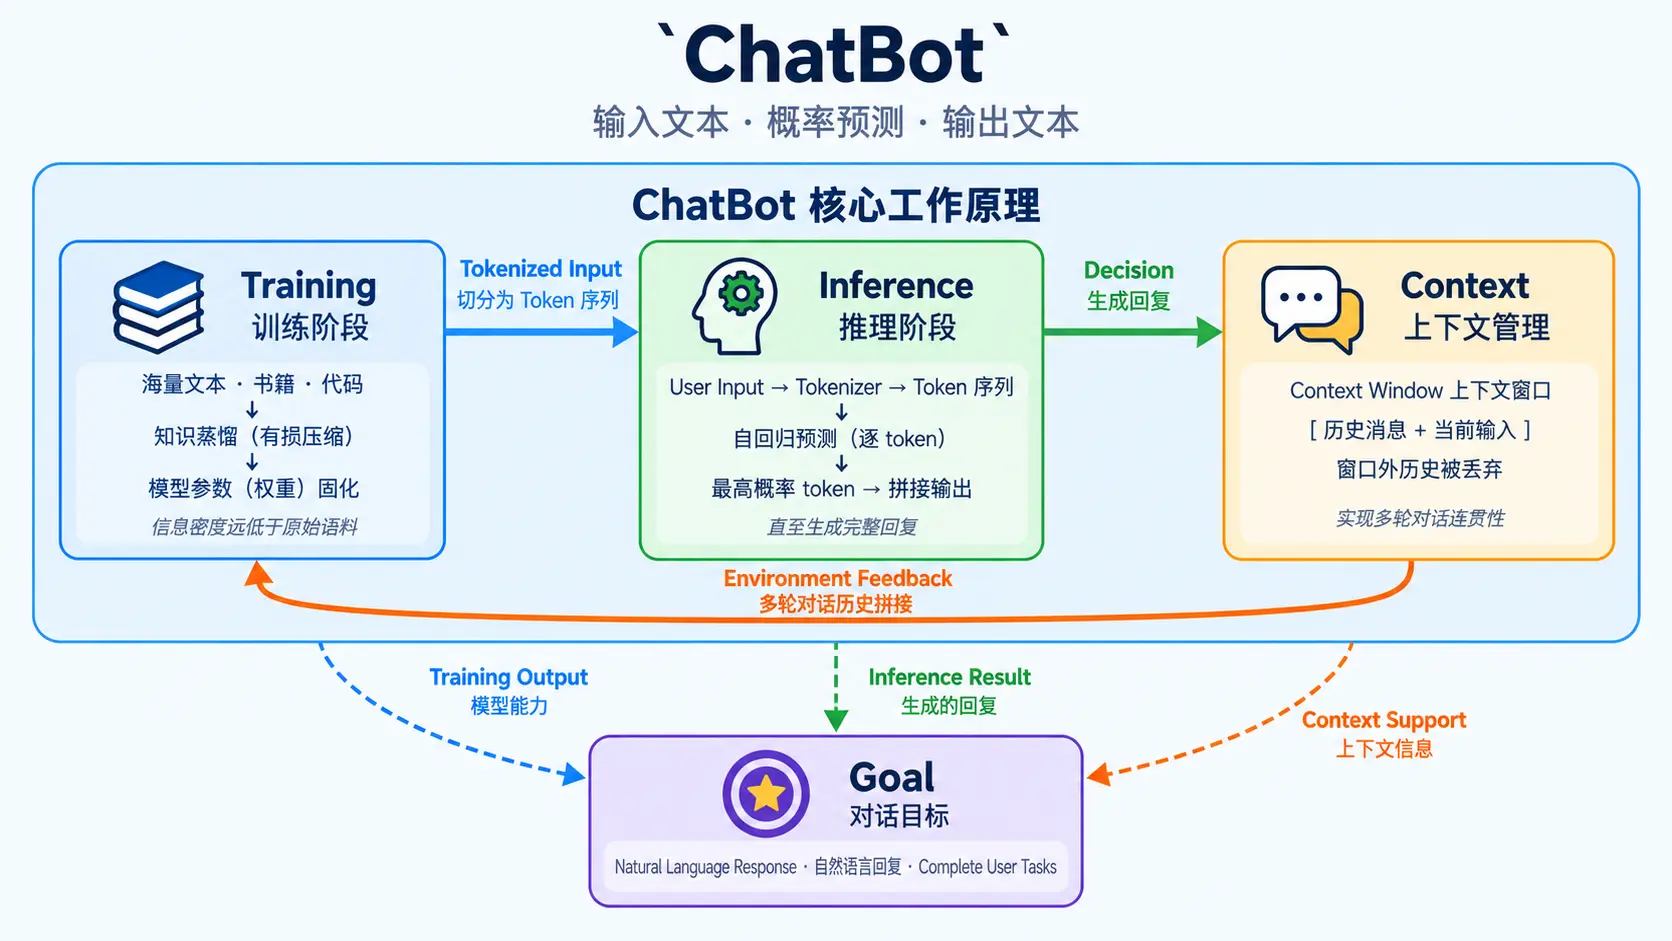
ChatBot 是建立在 LLM 基础能力之上的对话系统,通过自然语言与用户进行交互,本质是一个 “输入文本 → 概率预测 → 输出文本” 的生成模型。
核心实现原理:
| 环节 | 说明 |
|---|---|
| 训练阶段 | 海量互联网文本、书籍、代码等被处理为训练数据,经过有损压缩后固化为模型参数(权重)。这是一个”知识蒸馏”过程,信息密度远低于原始语料。 |
| 推理阶段 | 用户输入经过 Tokenizer 切分为 token 序列,模型基于自回归方式逐 token 预测下一个最可能的 token,直至生成完整回复。 |
| 上下文管理 | 模型厂商在推理时维护一个上下文窗口(Context Window),将当前会话的历史消息拼接后送入模型,实现多轮对话的连贯性。窗口外的历史会被丢弃。 |
核心局限性:
-
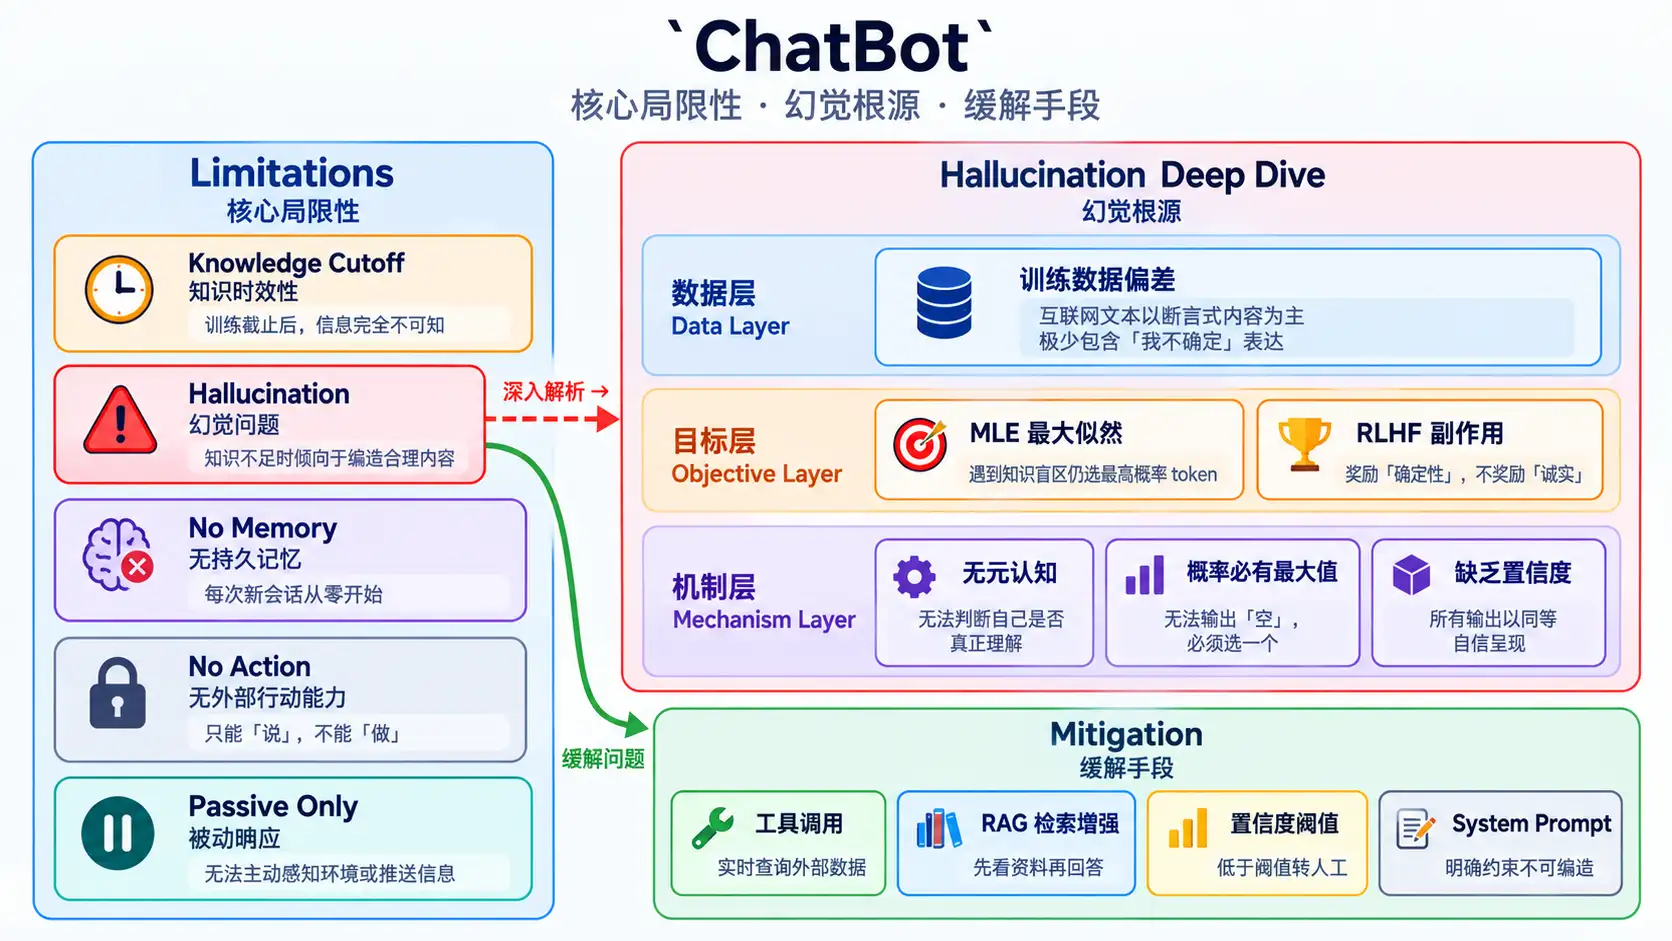
知识时效性:参数固化后无法感知世界变化,训练截止日期之后的信息完全不可知。
-
幻觉问题:当知识不足时,模型倾向于”编造”看似合理的内容,而非承认无知。
[!NOTE]
幻觉根源
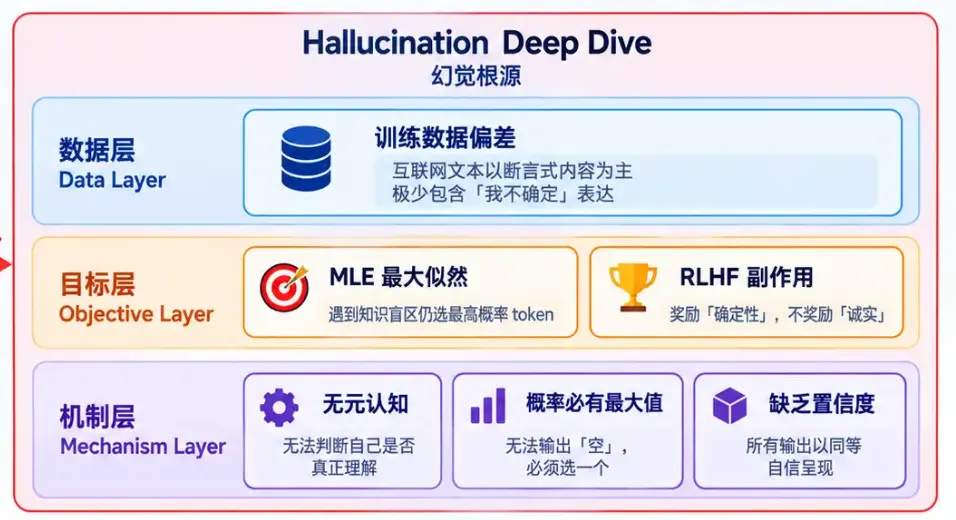
层次 原因 说明 数据层 训练数据的偏差 互联网文本以”断言式”内容为主(百科、教程、论坛回答),极少包含”我不确定”“这超出了我的知识范围”这类表达。模型模仿了数据的风格,却没学会数据的边界意识。 目标层 最大似然估计 (MLE) 训练和推理共享同一个目标:最大化下一个 token 的预测概率。当模型遇到知识盲区时,它仍然会从概率分布中选出”最可能的 token”,而不是输出”我不知道”。训练数据中极少出现”我不知道”的标注样本,模型根本没学会这个行为。 RLHF 的副作用 奖励”确定性”,不奖励”诚实”。人类偏好标注中,标注员倾向于给”自信、流畅、有信息量”的回答打高分。一个回答”我不知道”的模型,在偏好排序中天然处于劣势。 机制层 无元认知能力 LLM 本质是”下一个 token 预测器”,它没有内省机制来判断自己是否真的理解某个概念。它只知道”在这个位置,token X 的概率是 0.87”,但不知道”这个概率对应的知识是否正确”。 概率分布总是有最大值 无论输入什么,模型都会输出一个概率分布,且总有一个 token 的概率最高。模型无法输出”空”——它必须选一个。当知识不足时,它选出的就是”幻觉”。 缺乏不确定性量化 模型不会主动标注”这个回答的置信度很低”。它对自己生成的内容没有”把握度”的概念,所有输出都以同样的自信呈现。 幻觉的缓解手段
手段 原理 工具调用 不依赖参数知识,而是实时查询外部数据源——”不知道就去查” RAG 检索增强 先检索相关文档,再基于文档回答——”先看资料再说话” 置信度阈值 设定输出概率阈值,低于阈值时触发”我不知道”或转人工 System Prompt 约束 明确指令:”如果信息不足,请直接说不知道,不要编造” -
无持久记忆:每次新会话从零开始,无法积累用户偏好和历史行为。
-
无外部行动能力:只能”说”,不能”做”。无法调用 API、查询数据库、操作文件。
-
被动响应:只有用户发起对话才会回复,无法主动感知环境变化或推送信息。
RAG(检索增强生成)
为了弥补 ChatBot 在知识时效性和幻觉问题上的缺陷,开发者为 ChatBot 引入了从外部知识库检索的能力——RAG(Retrieval-Augmented Generation,检索增强生成)。
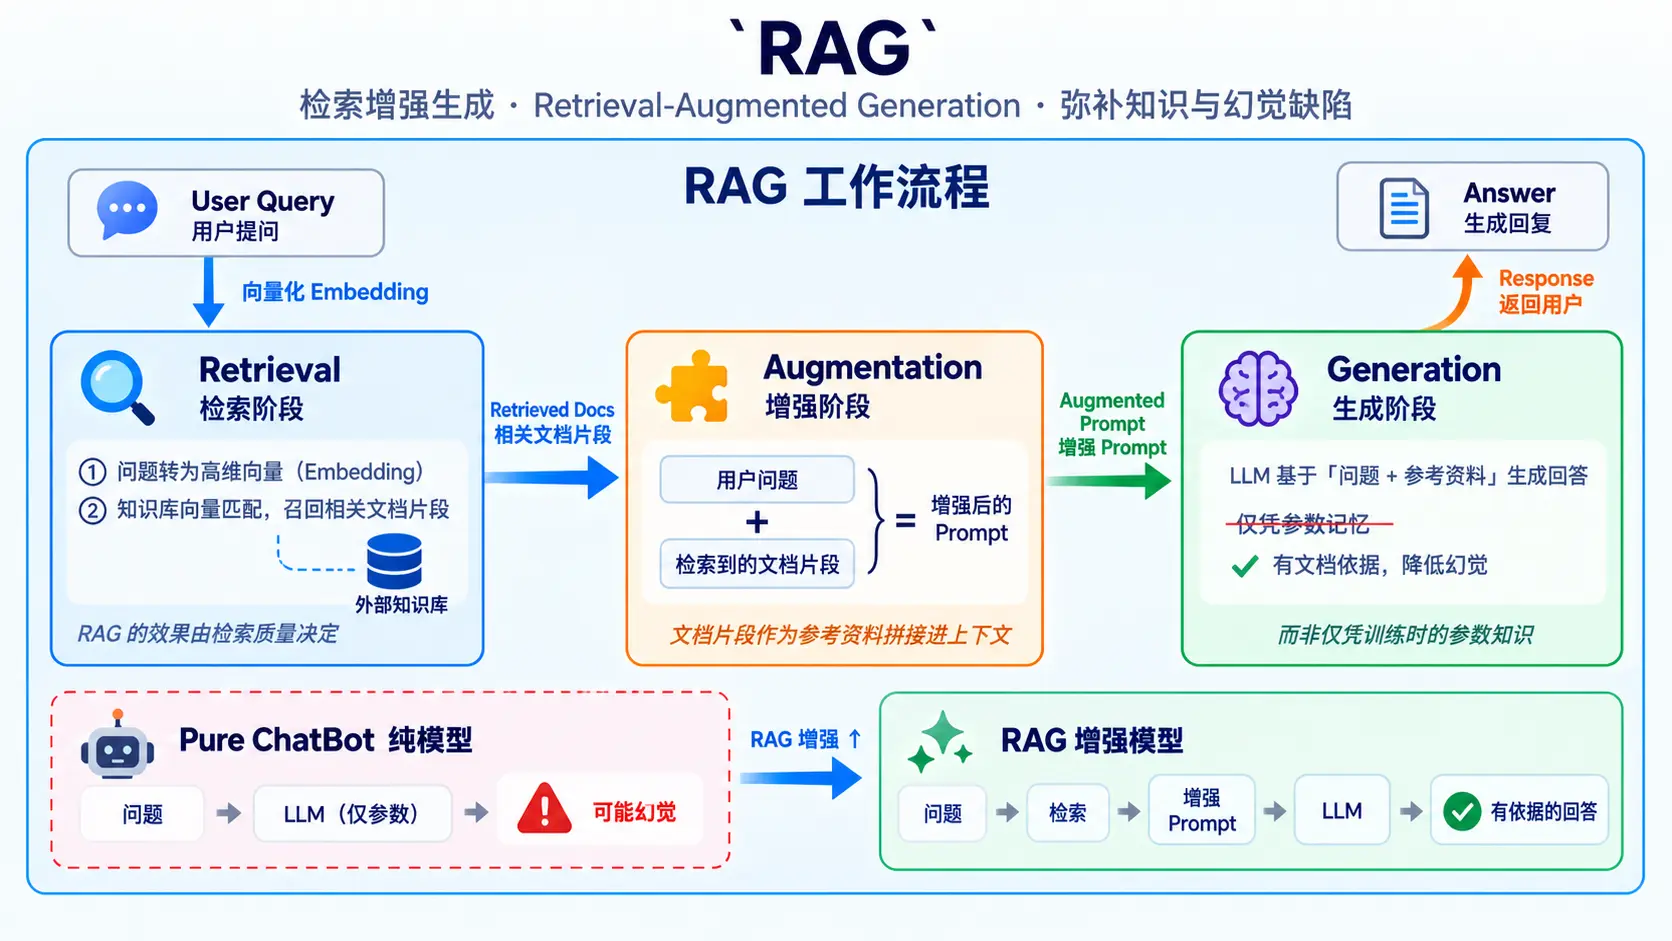
核心局限性:
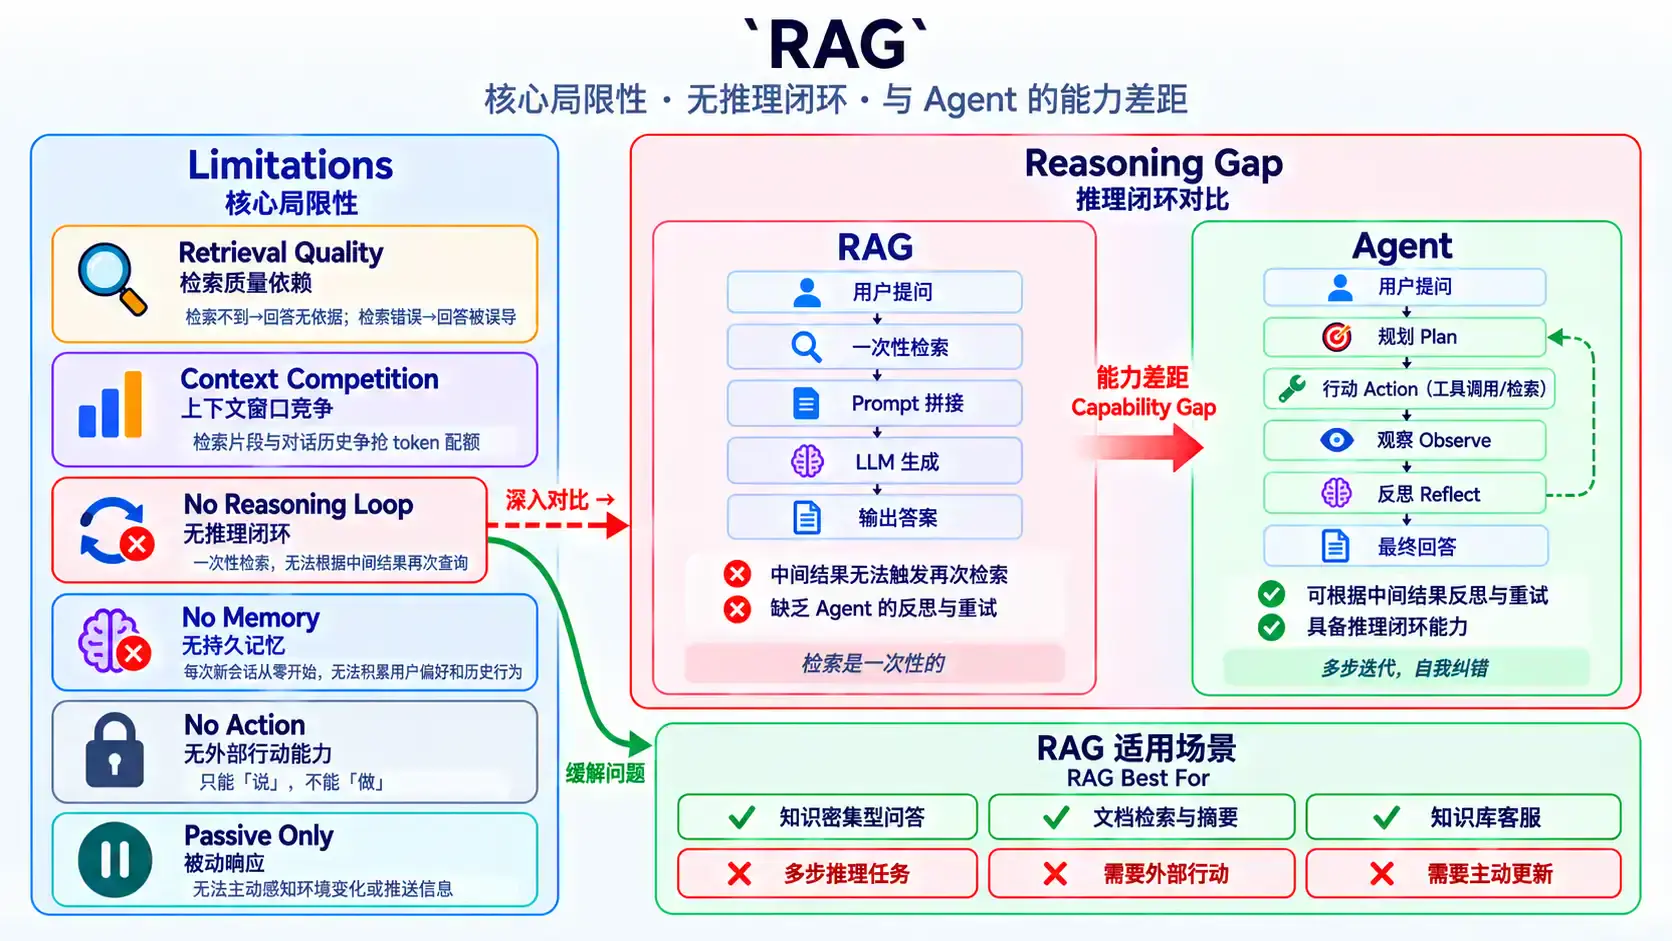
- 检索质量依赖:检索不到 → 回答无依据;检索错误 → 回答被误导。RAG 的效果由检索质量决定。
- 上下文窗口竞争:检索片段占用上下文窗口,与对话历史、系统指令争抢 token 配额。
- 无推理闭环:检索是一次性的,无法根据中间结果”再去查一下”。缺乏 Agent 的反思与重试能力。
- 无持久记忆:每次新会话从零开始,无法积累用户偏好和历史行为。
- 无外部行动能力:只能”说”,不能”做”。无法调用 API、查询数据库、操作文件。
- 被动响应:只有用户发起对话才会回复,无法主动感知环境变化或推送信息。
AI Workflow(AI 工作流)
Workflow 是在 ChatBot + RAG 基础上,将固定业务流程按照预设规则编排为可重复执行的自动化链路。如果说 RAG 解决了 ChatBot “不知道去哪儿查”的问题,Workflow 则进一步解决了”查完之后还能做什么”的问题。
核心实现原理:
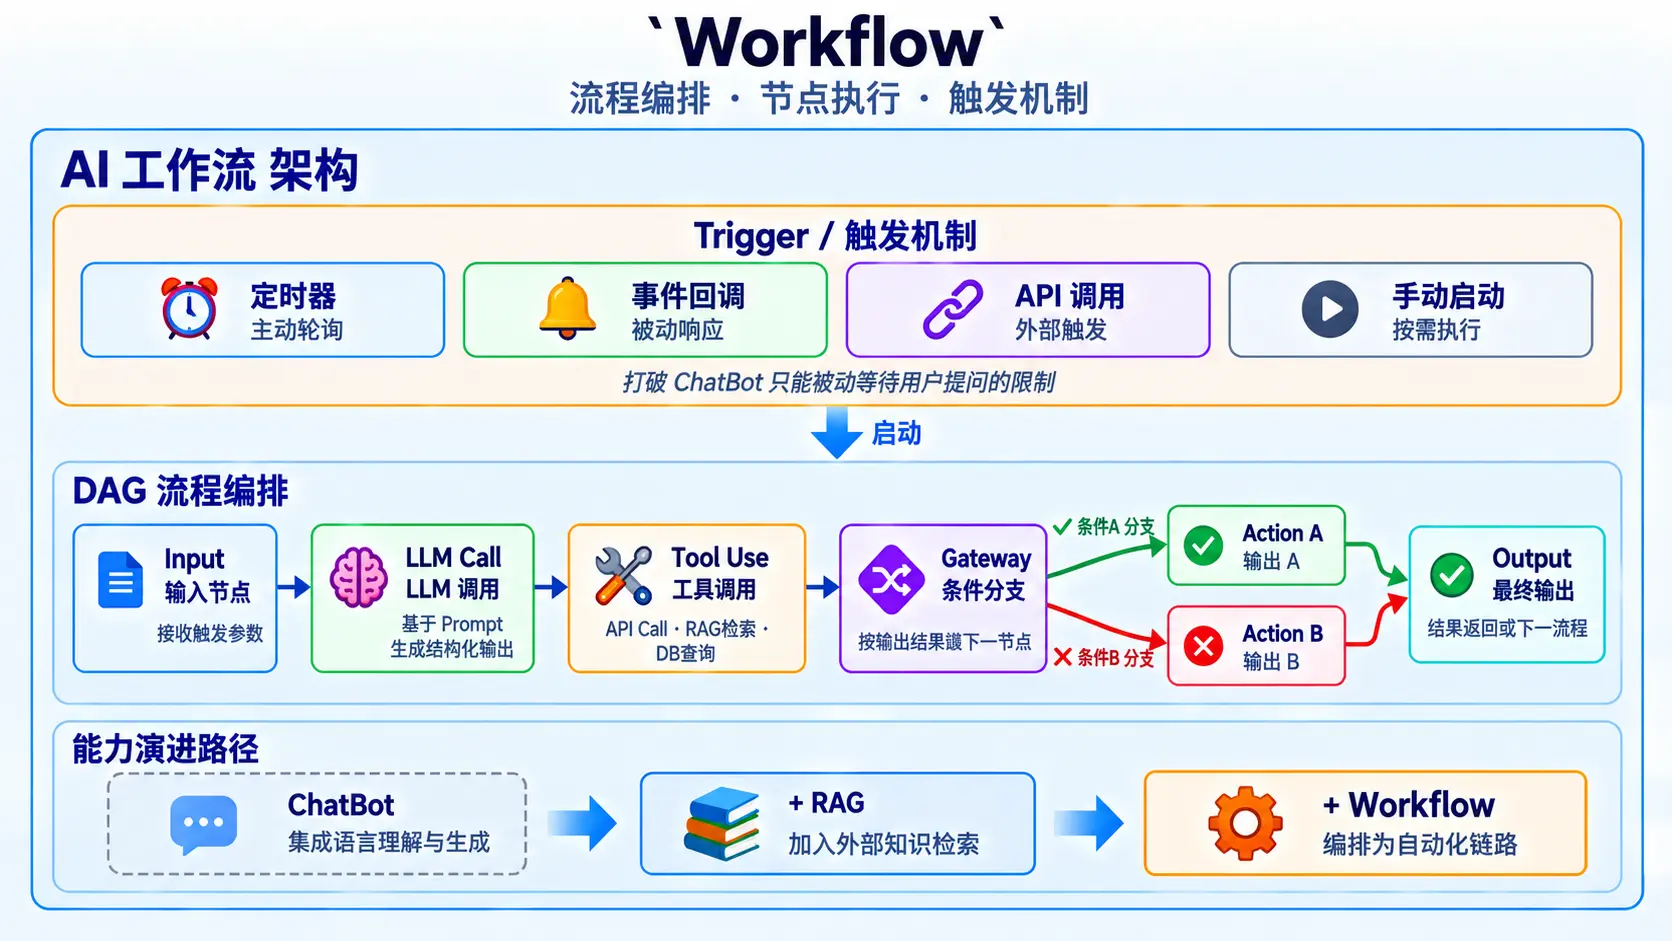
| 环节 | 说明 |
|---|---|
| 流程编排 | 将业务流程拆解为多个节点,按 DAG 或状态机定义执行顺序,固化在编排中。 |
| 节点执行 | 每个节点执行一个原子任务:API Call 、LLM Call、Tool Use、条件分支Gateway等,节点间通过结构化数据按预设规则传递状态信息。 |
| 触发机制 | 支持多种触发方式——定时器主动轮询、事件回调被动响应、API 外部调用、手动启动——打破 ChatBot 只能被动等待用户提问的限制。 |
核心局限性:
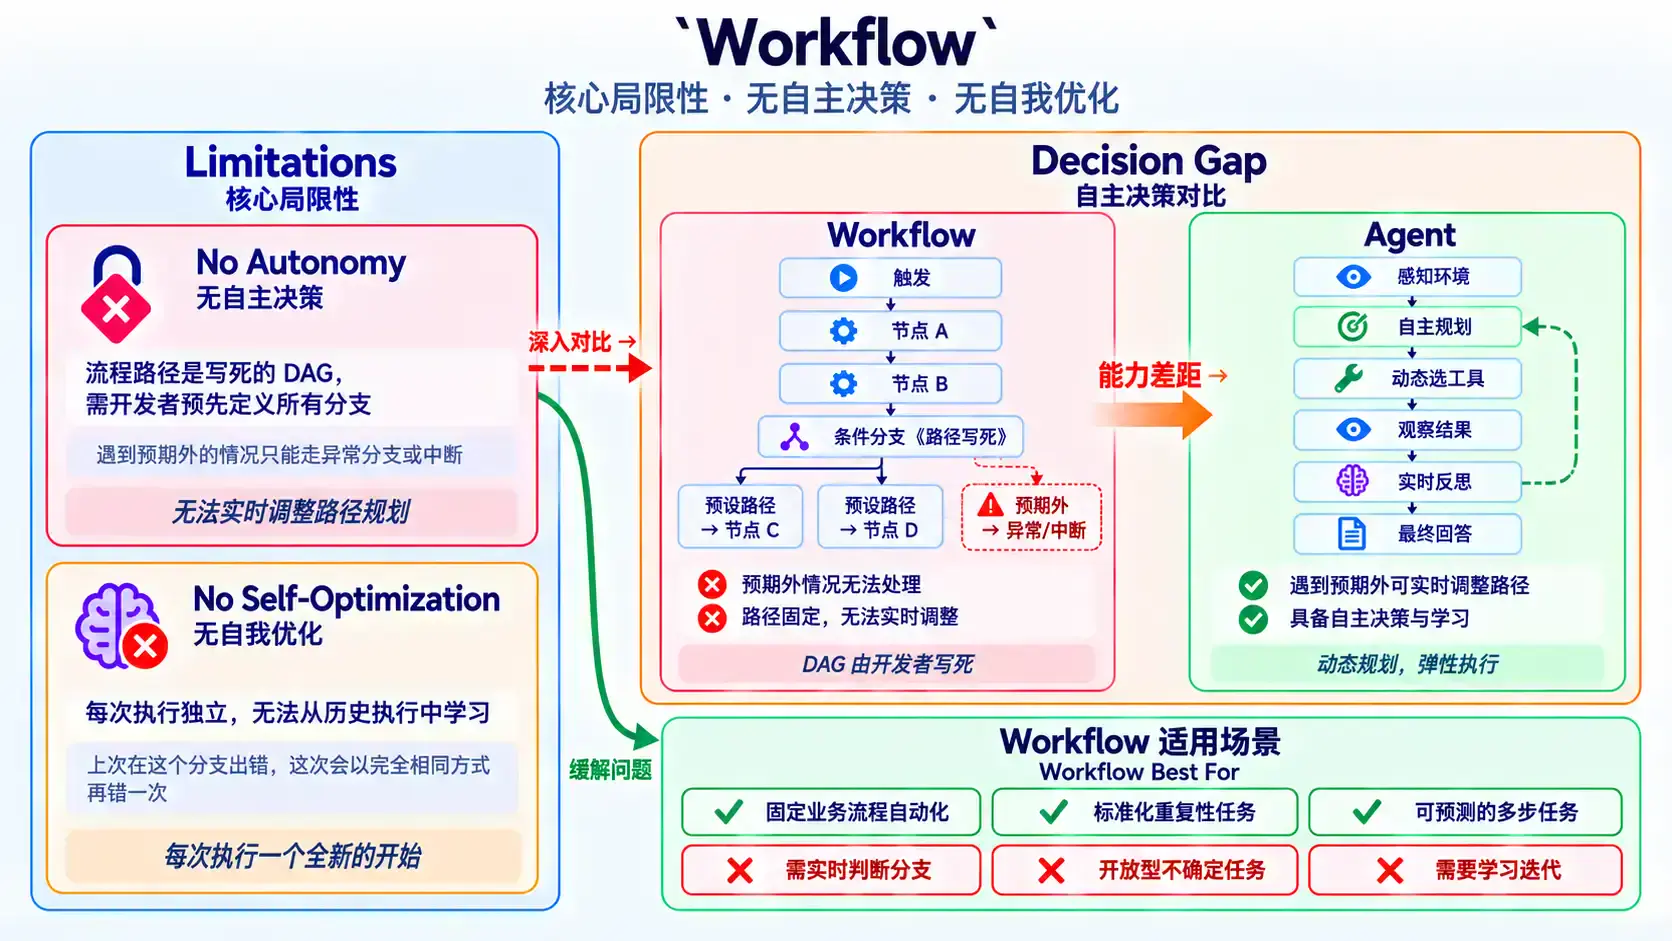
- 无自主决策:流程路径是写死的DAG,遇到预期外的情况只能走异常分支或中断。
- 无自我优化:每次执行独立,无法从历史执行中学习。上次在这个分支上出错了,这次会以完全相同的方式再错一次。
Agent
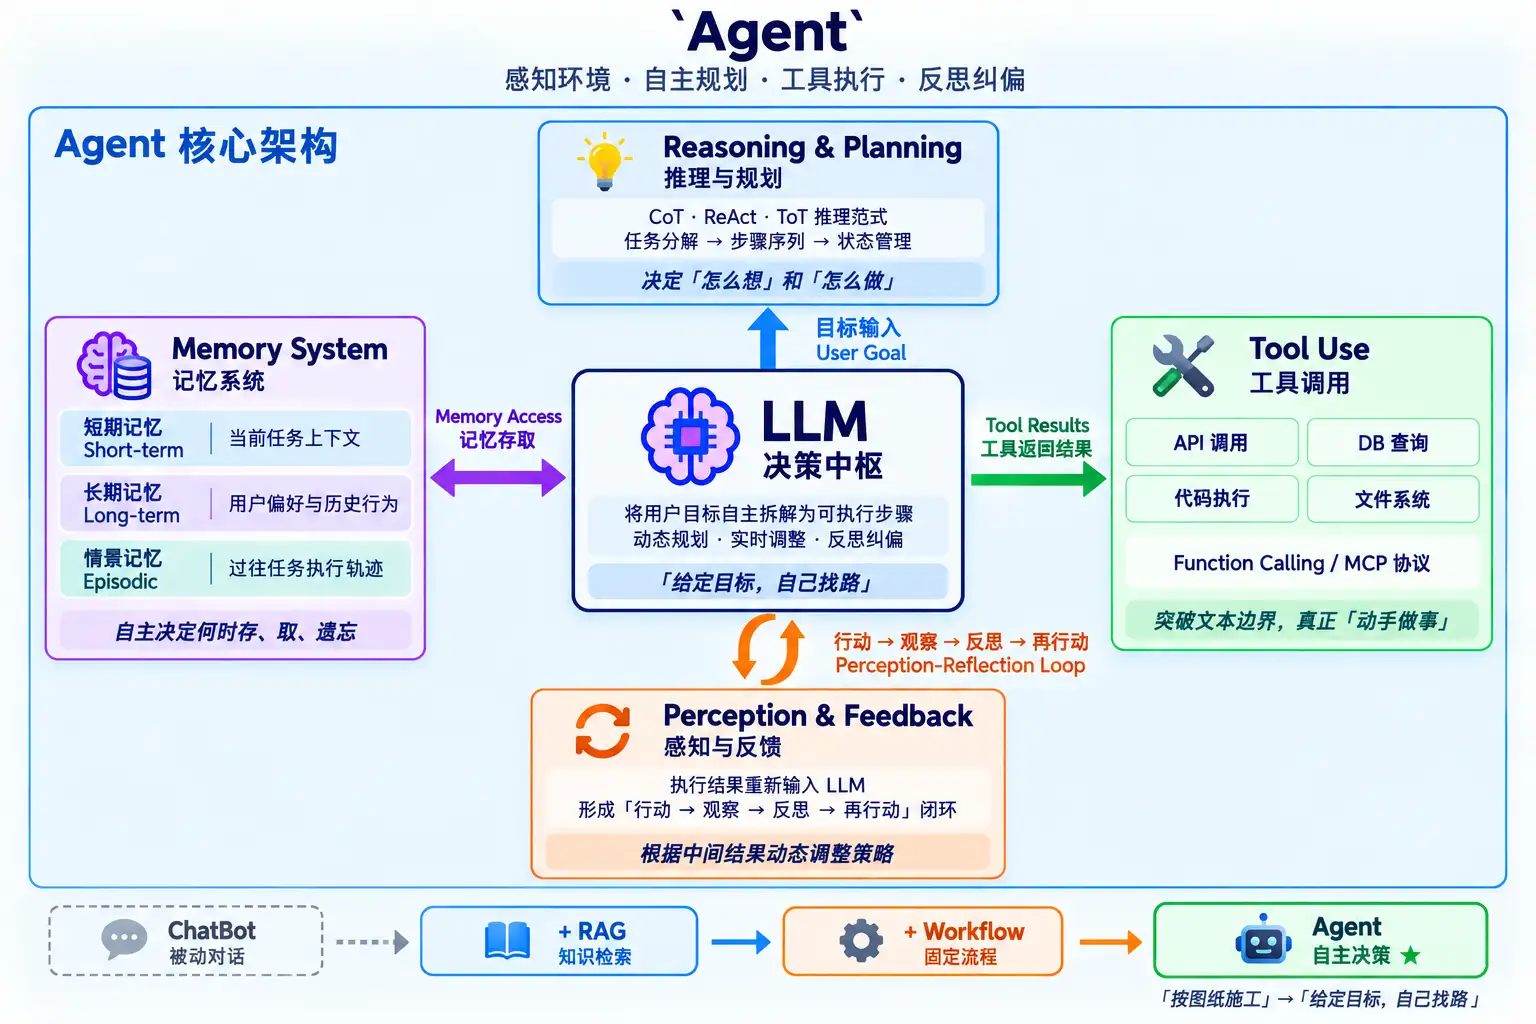
Agent 是在 Workflow 基础上的质变——它不再依赖预设路径,而是让 LLM 成为决策中枢,自主感知环境、推理规划、选择工具、执行行动,并在执行过程中持续反思与纠偏。如果说 Workflow 是”按图纸施工”,Agent 则是”给定目标,自己找路”。
核心实现原理:
| 环节 | 说明 |
|---|---|
| 推理与规划 | LLM 作为”大脑”,将用户目标自主拆解为可执行的步骤序列。推理范式(CoT、ReAct、ToT)决定了”怎么想”,规划策略(任务分解、状态管理、断点续传)决定了”怎么做”。 |
| 记忆系统 | 维护跨会话的持久记忆——短期记忆保存当前任务上下文,长期记忆积累用户偏好和历史行为,情景记忆回溯过往任务的执行轨迹。Agent 自主决定何时存、何时取、何时遗忘。 |
| 工具调用 | 通过 Function Calling / MCP 等协议调用外部工具(API、数据库、代码执行器、文件系统),突破 LLM 的文本边界,真正”动手做事”。 |
| 感知与反馈 | 执行结果重新输入 LLM,形成”行动 → 观察 → 反思 → 再行动”的闭环。Agent 根据中间结果动态调整策略,而非一条路走到黑。 |
2. 核心内核:单 Agent 架构
如果说 ChatBot 的核心是”生成”,RAG 的核心是”检索”,Workflow 的核心是”编排”,那么 Agent 的核心就是自主决策。单 Agent 架构围绕这一核心,将感知、思考、行动、记忆组织为一个闭环——Agent Loop。本章从执行循环出发,沿数据流方向逐一展开各子系统。
2.1 Agent Loop:单 Agent 的核心骨架
Agent 不是一次性”输入 → 输出”的静态函数,而是一个持续运行的闭环。它感知环境、自主思考、执行行动,然后基于新的观察再次推理——循环往复,直到目标达成或无法继续。
循环终止条件
终止条件 触发方式 示例 目标达成 模型判断任务已完成,输出最终回答 “已为你预订了明天下午 3 点的会议室” 步数上限 达到预设的最大循环次数 通常设为 10~50 步,防止死循环 无法继续 模型判断当前条件下无法完成任务 “抱歉,所需 API 不可用,无法完成查询” 人工介入 遇到高风险操作或模型主动请求确认 “即将删除 100 条记录,是否继续?”
2.2 感知:输入与理解
感知是 Agent Loop 的入口。它不只是”接收用户消息”,而是将多模态的原始输入转化为模型可理解的完整上下文。感知的质量直接决定了后续推理和行动的正确性。
2.2.1 多模态输入
-
文本
文本的优势是信息密度高、处理成本低,是 Agent 交互的主通道。
-
视觉
视觉输入的处理链路通常为:图像 → 视觉编码器(Vision Encoder)→ 视觉 token → 与文本 token 拼接 → 送入 LLM。多模态模型(如 GPT-4V、Gemini Pro Vision)将这一链路内置于模型中,Agent 无需额外的 OCR 或图像理解工具。
-
语音
语音输入的处理链路:音频 → ASR(语音识别)→ 文本 → 送入 LLM。对 Agent 而言,语音和文本在进入推理引擎之前已经统一——Agent 不需要”理解”音频,只需要理解转写后的文本。
2.2.2上下文组装(动态 Prompt 组装)
2.3 思考:推理与决策
2.3.1 推理引擎基础
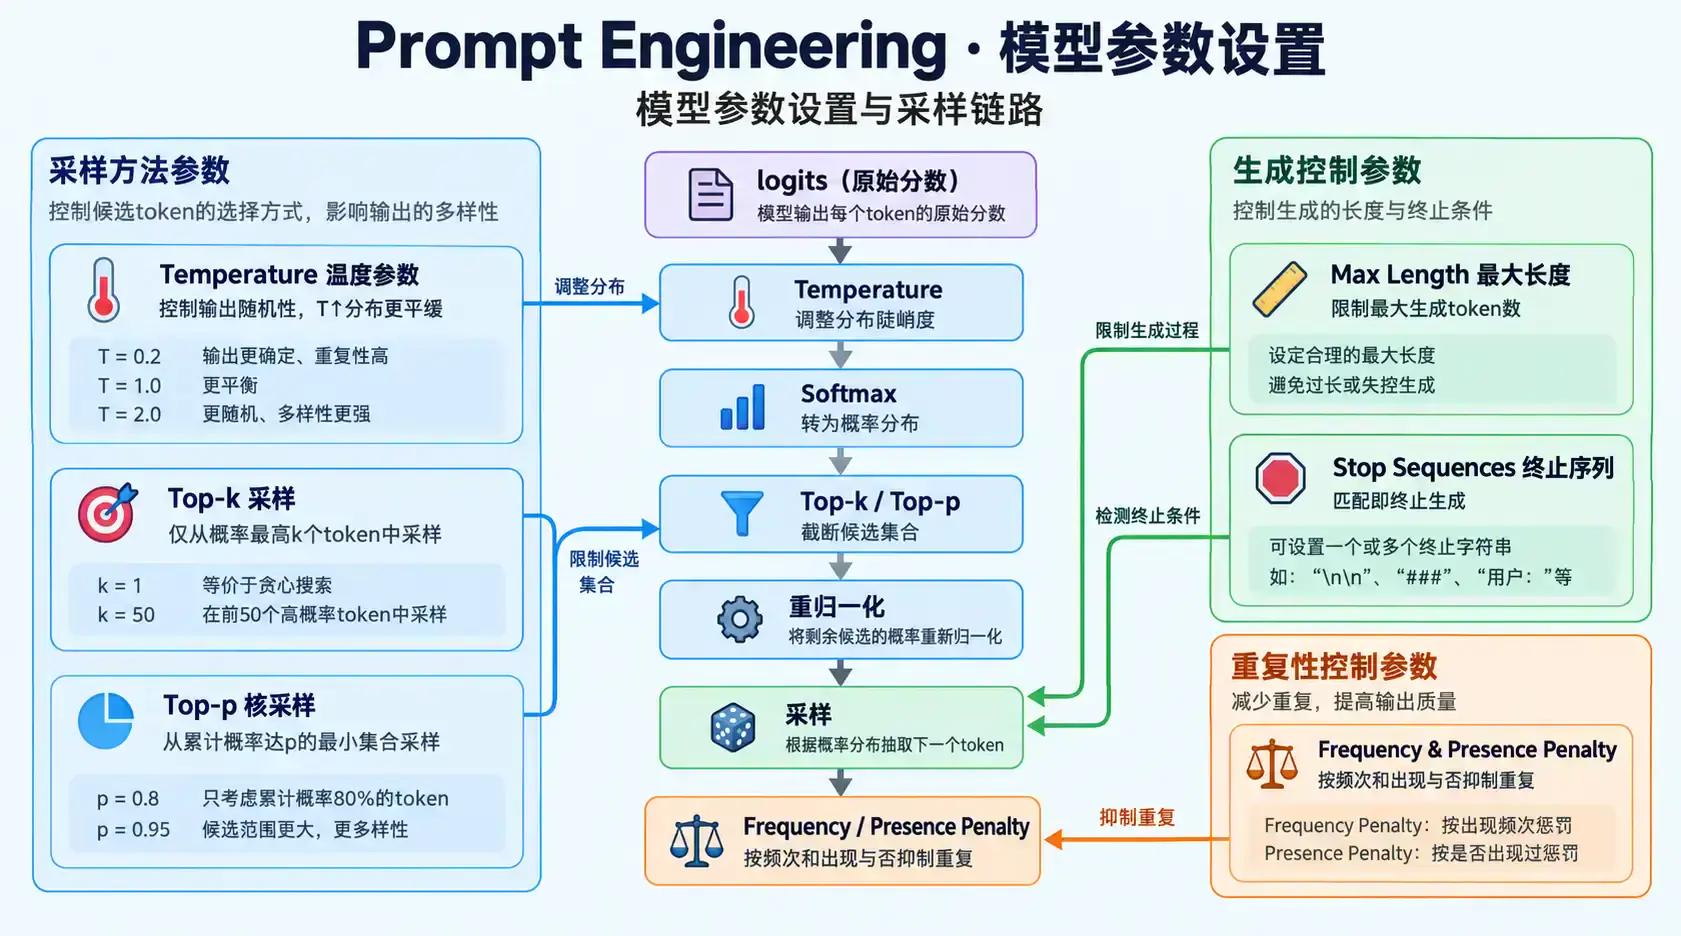
模型推理时的核心参数决定了输出的随机性、长度和重复控制。这些参数作用于模型输出的 logits(原始分数)到最终 token 的采样链路中,理解其数学原理是调优 Agent 行为的基础。
-
Temperature(温度)
Temperature 控制输出的随机程度,作用于 softmax 之前。
数学定义:
给定 logits 向量 $\mathbf{z} = [z_1, z_2, …, z_V]$,Temperature $T > 0$,调整后的 softmax 概率为:
$$ P(i) = \frac{e^{z_i / T}}{\sum_{j=1}^{V} e^{z_j / T}} $$极限行为:
$T$ 取值 行为 数学解释 $T \to 0$ 确定性输出(贪心解码) $\lim_{T \to 0} P(i) = \begin{cases} 1 & \text{if } i = \arg\max(\mathbf{z}) \ 0 & \text{otherwise} \end{cases}$ $T = 1$ 原始分布,不做调整 $P(i) = \text{softmax}(z_i)$ $T \to \infty$ 均匀分布 $\lim_{T \to \infty} P(i) = \frac{1}{V}$ 设置 效果 适用场景 0 ~ 0.3 几乎确定性输出,每次结果高度一致 代码生成、数学计算、事实问答、数据提取 0.5 ~ 0.7 适度随机,有一定变化但不离谱 通用对话、文档撰写、翻译 0.8 ~ 1.0 明显随机,输出多样性强 创意写作、头脑风暴、文案生成 > 1.0 高度随机,可能产生不连贯内容 极少使用,通常无实用价值 -
Top-k 采样
只从概率最高的 $k$ 个 token 中采样,其余 token 概率置零后重归一化。
数学定义:
设按概率降序排列后的 token 集合为 $\mathcal{V}_{\text{sorted}}$,取前 $k$ 个构成候选集 $\mathcal{V}_k$:
$$ \mathcal{V}_k = \{i \in \mathcal{V}_{\text{sorted}} \mid \text{rank}(i) \leq k\} $$重归一化:
$$ P_{\text{top-k}}(i) = \begin{cases} \frac{P(i)}{\sum_{j \in \mathcal{V}_k} P(j)} & \text{if } i \in \mathcal{V}_k \\ 0 & \text{otherwise} \end{cases} $$局限性: 固定 $k$ 无法适应不同位置的分布差异——分布集中时候选池太宽(低概率噪声被纳入),分布平坦时候选池太窄(有意义的 token 被排除)。
-
Top-p 采样(Nucleus Sampling)
只从累计概率达到 $p$ 的最小 token 集合中采样。候选池大小随分布自适应。
数学定义:
设 $p \in (0, 1]$,找到最小的候选集 $\mathcal{V}_p$ 满足:
$$ \mathcal{V}_p = \arg\min_{\mathcal{V}' \subseteq \mathcal{V}} |\mathcal{V}'| \quad \text{s.t.} \quad \sum_{i \in \mathcal{V}'} P(i) \geq p $$重归一化同 Top-k。
对比:
参数 候选池 优点 缺点 Top-k 固定大小 $k$ 实现简单,延迟可预测 无法自适应分布变化 Top-p 动态大小 自适应分布,分布集中时更确定,平坦时更多样 候选池大小不可预测 推荐设置 场景 Top-p = 0.9 ~ 0.95 通用场景,平衡多样性和质量 Top-p = 0.1 ~ 0.5 需要确定性输出的场景 通常 Temperature + Top-p 组合使用,不叠加 Top-k。
-
Max Length(最大长度)
限制模型单次生成的最大 token 数 $N_{\text{max}}$。生成过程在第 $N_{\text{max}}$ 步强制终止。
要点 说明 设置过低 回答被截断,关键信息丢失 设置过高 浪费 token 和延迟,且可能诱发模型”没话找话” 建议 根据场景预估输出长度,留 20%~30% 余量。对话场景通常 1024~4096 token,代码生成可能需要更高 -
Stop Sequences(停止序列)
指定停止序列集合 $\mathcal{S} = {s_1, s_2, …, s_m}$。生成过程中,一旦已生成的 token 序列末尾匹配任一 $s \in \mathcal{S}$,立即停止。停止序列本身不包含在输出中。
数学定义:
设已生成序列为 $\mathbf{y}{<t} = [y_1, y_2, …, y{t-1}]$,若存在 $s \in \mathcal{S}$ 使得:
$$ \mathbf{y}_{则生成终止,最终输出为 $\mathbf{y}_{<t}[:- s ]$。 用途 示例 控制输出边界 设置 "\n\n"防止模型在回答后继续”自言自语”多轮对话分隔 设置 "User:"或"Human:"防止模型替用户说话结构化输出终止 设置 "``”或”</output>”` 控制代码块或 XML 输出的结束Function Calling 设置 "</function_call>"确保工具调用格式完整且不追加多余内容Frequency Penalty 和 Presence Penalty
两者都用于抑制重复,通过修改下一 token 的 logits 实现。惩罚在每一轮采样后累积作用于后续生成。
数学定义:
设已生成序列中 token $i$ 的出现次数为 $c_i$,原始 logits 为 $z_i$,调整后 logits 为 $\tilde{z}_i$:
$$ \tilde{z}_i = z_i - \alpha \cdot c_i - \beta \cdot \mathbf{1}_{[c_i > 0]} $$其中:
- $\alpha$:Frequency Penalty,按出现次数成比例惩罚
- $\beta$:Presence Penalty,出现即施加固定惩罚
- $\mathbf{1}_{[c_i > 0]}$ 为示性函数,token 出现过则为 1,否则为 0
设置建议 场景 都为 0 无重复抑制,适合短回答、代码生成 $\alpha$ = 0.3, $\beta$ = 0.3 轻度抑制,通用对话 $\alpha$ = 0.5~1.0, $\beta$ = 0.5~1.0 明显抑制,适合长文生成、创意写作 过高(> 1.5) 可能导致用词生硬、语义断裂 注意:对于 Agent 场景,通常保持较低值(0.1~0.3),因为工具调用和结构化输出对重复不敏感,过高的惩罚反而可能破坏 JSON 或代码格式。
2.3.2 提示工程
提示策略决定”你怎么把问题喂给模型”。
提示工程(Prompt Engineering)是一门关注与大语言模型交互和研发的各种技能和技术的学科,主要包括提示词开发、优化与模型参数调优。它的核心问题是:如何用自然语言精确控制模型的输出行为?
-
System Prompt(系统提示词)
System Message 一般都是出现在输入的开始,根据大模型注意力机制的公式,在开始和结尾处的文字更容易被重视。
为什么开头的 token 被重视:注意力被”强制分配”。序列开头的 token 被后面每一个 token 关注,且在后几个 token 的位置上,由于分母很小,它们分到的注意力权重天然较高。
为什么结尾的 token 被重视:生成时的”最近因”。自回归生成中,相邻 token 之间的语义关联最强——上一个 token 直接决定了下一个 token 的语法和语义空间。因此结尾处的 token(最近的对话、最新的指令)天然获得最高的注意力权重。
System Prompt 用于定义模型的角色、行为边界、输出格式和核心约束。它在每次推理时作为隐式前缀注入,优先级高于用户消息,是控制模型行为最基础也最有效的手段。
System Prompt 的四要素:
要素 说明 示例 角色定义 模型的身份和定位 “你是一个资深的代码审查专家,专注于 Java 后端代码” 行为边界 什么能做、什么不能做 “只审查代码质量和安全问题,不修改业务逻辑,不重构代码结构” 输出格式 回答的结构要求 “以 JSON 格式返回,包含 severity、file、line、suggestion 四个字段” 核心约束 不可违反的铁律 “如果信息不足以做出判断,直接说’信息不足’,不要编造” -
Zero-shot(零样本提示)
经过大量数据训练和对齐的 LLM 能够直接执行任务,不需要提供任何示例。这是提示工程最基础的形态——用户描述任务,模型直接输出结果。
请将以下文本翻译成英文:
"人工智能正在改变世界"
工作原理: 模型在训练阶段已经见过大量”翻译任务”的数据模式(SFT 阶段的对齐训练进一步强化了这种能力),因此当 Prompt 中出现”翻译成英文”这个指令时,模型能够从参数知识中激活对应的行为模式。
能力来源:
阶段 作用 预训练 从海量语料中学习语言模式和任务格式 SFT(监督微调) 用高质量的”指令-回答”对训练,让模型学会遵循指令 RLHF(人类反馈强化学习) 用人类偏好数据优化,让模型的回答更符合人类期望 局限: 零样本的瓶颈在于——模型只能依靠参数知识”猜测”任务意图。对于复杂、领域特定或需要精确控制输出的任务,”猜测”可能偏离预期。这就是
Few-shot存在的意义。 -
Few-shot(少样本提示)
在 Prompt 中提供少量示例(通常 2~5 个),让模型通过模式匹配理解任务。示例的作用不是”教会模型新知识”,而是”校准模型对任务格式和预期的理解”。
将以下中文短语翻译成英文:

中文:机器学习
英文:Machine Learning

中文:深度学习
英文:Deep Learning

中文:强化学习
英文:
为什么有效: LLM 本质是”下一个 token 预测器”。当 Prompt 中出现
中文:X → 英文:Y的重复模式后,模型会倾向于延续这个模式——在最后一个中文:强化学习 → 英文:的位置,模型自然预测出Reinforcement Learning。示例设计要点:
要点 说明 示例数量 通常 2~5 个,过多会挤占上下文窗口且边际收益递减 示例质量 格式一致性比数量更重要。格式不一致的示例会误导模型 示例覆盖 尽量覆盖边界情况(如空输入、异常格式),让模型学会”遇到这种情况该怎么处理” 示例顺序 简单示例在前,复杂示例在后;或随机排列避免位置偏差 局限: 对于需要多步骤推理的任务(如数学计算、逻辑推理),仅靠示例模仿无法保证推理正确性——模型可能学会了格式,但没学会逻辑。比如给两个”计算总价”的示例,模型能模仿格式输出一个数字,但数字本身可能是错的。这就引出了
CoT。 -
Chain of Thought(CoT,思维链)
CoT 是提示工程的第一个质变——在 Few-shot 示例中加入中间推理步骤,引导模型在回答前”先思考再作答”。这是从”模式匹配”到”逻辑推理”的跨越。
普通 Few-shot(无推理过程):
Q: 一个农场有 15 只鸡和 8 只兔子,一共有多少条腿?
A: 62 条腿
模型只能模仿格式输出一个数字,但数字对不对取决于模型能否在”一步之内”完成计算——这对复杂问题是不可靠的。
CoT Few-shot(含推理过程):
Q: 一个农场有 15 只鸡和 8 只兔子,一共有多少条腿?
A: 鸡有 2 条腿,15 只鸡共 15 × 2 = 30 条腿。
   兔子有 4 条腿,8 只兔子共 8 × 4 = 32 条腿。
   30 + 32 = 62 条腿。
   答案:62 条腿。
为什么有效:
机制 说明 问题分解 将复杂问题拆解为多个简单子问题,每个子问题的计算量变小,模型更容易正确完成 思考锚点 中间步骤生成的 token 作为后续推理的”锚点”,自回归机制使得模型在生成下一步时能”看到”之前的推理过程 错误定位 即使最终答案错误,中间步骤也让错误可追溯——你能看到模型在哪一步算错了 -
Self-Consistency CoT(自我一致性)
对同一问题采样多条 CoT 推理路径,取出现频率最高的答案作为最终结果。核心假设是:正确的推理路径可能不同,但正确的答案应该收敛。
同一问题 × N 次采样(Temperature > 0,通常 N = 5~10)
    │
    ├── 路径 1: "鸡 30 + 兔 32 = 62" → 答案 62
    ├── 路径 2: "15×2=30, 8×4=32, 30+32=62" → 答案 62
    ├── 路径 3: "鸡 15 只 30 腿, 兔 8 只 32 腿, 共 62" → 答案 62
    ├── 路径 4: "15×4=60, 8×2=16, 共 76" → 答案 76(错误路径)
    └── 路径 5: "鸡 30 + 兔 32 = 62" → 答案 62

    多数投票:62(4 票) > 76(1 票) → 最终答案: 62
关键参数:
参数 作用 建议值 采样次数 N 路径越多,投票越可靠 5~10,边际收益在 10 以后递减 Temperature 控制路径多样性 0.5~0.7,太低路径趋同,太高产生噪声 适用条件:
条件 说明 答案可枚举 任务有确定的正确答案(数学、逻辑、分类),开放性问题不适用 路径多样但答案收敛 不同推理路径能得到相同答案时效果最好;如果正确答案本身就是多样的(如”推荐一部电影”),投票无意义 局限: 成本是普通 CoT 的 N 倍。且当错误答案恰好占多数时(模型系统性偏见导致的),投票反而强化了错误。
-
Generated Knowledge(生成知识)
在回答之前,先让模型生成与问题相关的背景知识,再基于这些知识作答。本质是”让模型自己给自己提供参考资料”——将参数知识显式化为文本,作为后续推理的素材。
两步流程:
Step 1: 生成知识
Prompt: "请列出关于量子计算的关键事实"
    → 模型输出:
      1. 量子比特可以同时处于 0 和 1 的叠加态
      2. 量子纠缠允许远距离量子比特瞬时关联
      3. 量子计算机在质因数分解上远超经典计算机
      ...

Step 2: 基于知识回答
Prompt: "根据以下知识:
       [Step 1 的输出]

       问题:为什么量子计算机能破解 RSA 加密?
       请基于上述知识回答。"
    → 模型基于自己生成的知识作答
为什么有效:
机制 说明 知识外化 将隐式的参数知识转为显式文本,减少了模型在推理时”回忆”知识的认知负担 推理锚定 后续回答被生成的知识”锚定”,降低了凭空编造的概率 可审查性 生成的知识可以被验证(是否正确、是否相关),不正确的知识可以被替换为外部知识 局限: 生成的知识本身可能包含错误(模型在 Step 1 就编造了假知识),导致 Step 2 基于错误前提推理。对于需要外部实时信息的任务,应使用 RAG 替代 Generated Knowledge。
-
Prompt Chaining(提示链)
将复杂任务拆解为多个子任务,每个子任务由独立的 LLM 调用完成,前一步的输出作为后一步的输入。这是提示工程从”单次调用”走向”工程化编排”的标志。
流程:
[输入文档: 一篇 5000 字的技术报告]
    │
    ▼ Prompt 1: "提取文档中所有的关键日期、事件和决策"
    │   输出: 结构化的事件列表
    │
    ▼ Prompt 2: "将上述事件按时间顺序排列,标注因果关系"
    │   输出: 时间线 + 因果链
    │
    ▼ Prompt 3: "基于排序后的事件和因果关系,写一篇 200 字的执行摘要"
    │   输出: 摘要
    │
    ▼ Prompt 4: "检查摘要是否准确反映了原始文档的关键信息,如有偏差请修正"
        输出: 最终摘要
Prompt Chaining vs CoT:
维度 CoT Prompt Chaining 调用次数 单次 LLM 调用 多次 LLM 调用 推理位置 模型内部(上下文窗口内) 外部串联(调用间独立) 上下文管理 所有推理步骤共享窗口,长链可能溢出 每步可裁剪上下文,只传递必要信息 工具集成 无法在推理中途调用外部工具 任意步骤之间可插入工具调用、人工审核 错误处理 中间步骤出错无法单独修正 每步输出可独立验证和重试 可观测性 所有推理在模型内部,黑盒 每步输入输出透明,可追踪调试 使用场景
场景 说明 多步骤文档处理 提取 → 分析 → 总结,每步对输出的格式和精度要求不同 需要人工审核的流程 在关键步骤之间插入人工确认节点 上下文窗口受限 单次调用装不下完整推理过程时,用 Chaining 拆分 混合工具调用 某一步需要查数据库、调 API,下一步基于结果继续推理
2.3.3 推理范式
推理范式决定”模型拿到问题后在内部怎么处理”。
范式 结构 核心机制 适用场景 CoT 线性 逐步推理,单链前进 数学、逻辑 ReAct 线性 + 工具 思考与行动交替,观察结果后调整 需要外部信息的任务 ToT 树 多分支探索 + 评估剪枝 需要探索多种方案 GoT 图 多分支融合 + 信息汇聚 综合多视角分析 Self-Refine 循环 迭代自我批评与修正 需要高质量输出 CoT(Chain of Thought,思维链)
CoT 已在 2.3.2 节作为提示策略详细讨论。从推理范式的视角看,CoT 的核心价值在于:将隐式推理显式化。模型不再从问题直接跳到答案,而是生成一系列中间推理步骤,每一步的 token 作为下一步推理的”锚点”,自回归机制让模型能”看到”自己之前的思考。
CoT 的本质约束是线性——推理只能沿单链前进,无法回溯,也无法探索替代路径。当推理路径本身需要试错(如”先假设 X,如果不对再换 Y”)时,单链 CoT 力不从心。这就引出了 ToT。
ReAct(Reasoning + Acting,推理与行动交替)
ReAct 是 Agent 领域最核心的推理范式。它将 CoT 的纯推理循环扩展为思考与行动交替的闭环:
Thought: 我需要知道上周的销售额才能做同比分析
Action: search_database("上周销售额")
Observation: 上周总销售额 85 万

Thought: 现在需要去年同期数据做对比
Action: search_database("去年同期销售额")
Observation: 去年同期 100 万

Thought: 同比下降了 15%,需要找出下降最严重的品类
Action: search_database("上周各品类销售额明细")
Observation: 电子产品 -30%,家居 -5%,服装 +10%

Thought: 已有完整数据,可以给出分析结论
Answer: 上周总销售额 85 万,同比下降 15%……
ReAct 循环的三个阶段:
阶段 内容 作用 Thought 模型分析当前状态,决定下一步做什么 推理中枢:判断需要什么信息、调用什么工具 Action 模型输出工具调用指令 执行层:调用 API、查询数据库、运行代码 Observation 工具返回结果,重新输入模型 反馈闭环:结果成为下一轮 Thought 的输入 为什么 ReAct 有效:
- 推理与行动解耦: 模型不需要在参数中存储所有知识——”不知道就去查”。这直接缓解了幻觉问题。
- 动态纠偏: Observation 可能推翻之前的 Thought。模型看到”去年同期 100 万”后,意识到不是增长而是下降,推理方向随之调整。
- 可解释性: 每一步 Thought 都是可审计的——你能看到模型为什么调用这个工具、如何解读返回结果。
ReAct 的局限: 线性结构决定了它一次只能探索一条路径。当面临”方案 A 和方案 B 哪个更好”的决策时,ReAct 只能先试一个,不行再回头——而回头意味着浪费了前面的 token 和时间。ToT 正是为解决这一局限而设计的。
ToT(Tree of Thoughts,思维树)
ToT 将推理从”单链前进”升级为”多分支探索”。模型在关键决策点生成多个候选思路(分支),评估每个分支的前景,选择最有希望的方向深入,必要时回溯。
ToT 的四个核心操作:
操作 说明 类比 生成(Generate) 在当前位置生成多个候选下一步 “有哪些可能的走法?” 评估(Evaluate) 对每个候选打分,判断前景 “这步走下去有希望吗?” 选择(Select) 按评估结果选择深入方向 “选最有希望的分支” 回溯(Backtrack) 当前分支无望时返回上级节点 “这条路走不通,换一条” 搜索策略: BFS(广度优先)适合需要全局比较的场景,DFS(深度优先)适合快速验证单条路径。实际工程中通常使用 Beam Search——每层保留 Top-K 个最优分支,平衡探索广度和计算成本。
GoT(Graph of Thoughts,思维图)
GoT 将推理建模为有向图而非树。图中节点是”想法”(Thought),边是”依赖关系”。关键创新在于:多个分支的中间结果可以融合(Merge)成一个新想法。
任务:写一篇关于"AI 对教育的影响"的文章大纲

分支 A(从学生视角):
  A1: AI 个性化辅导 → A2: 自适应学习路径 → A3: 减少重复练习

分支 B(从教师视角):
  B1: AI 自动批改作业 → B2: 学情数据分析 → B3: 精准教学干预

分支 C(从系统视角):
  C1: 教育资源不均衡 → C2: AI 降低优质教育门槛

融合(Merge):
  A3 + B3 + C2 → "AI 同时从学生、教师、系统三个层面重塑教育:
                 个性化学习 + 精准教学 + 普惠化"
GoT 的三种图操作:
操作 图结构变化 说明 聚合(Aggregate) 多个节点 → 1 个节点 将几个想法合并为一个更完整的想法 精炼(Refine) 1 个节点 → 1 个改进节点 对现有想法迭代改进 生成(Generate) 1 个节点 → 多个子节点 从一个想法派生出多个方向 Self-Refine(自我精炼)
Self-Refine 的核心思想是:让模型成为自己的批评者。它不是多分支探索,而是单链迭代——生成 → 自我批评 → 修正 → 再批评 → 再修正,直到输出满足质量要求。
Iteration 1:
  Generate: "AI 可以用于教育,它可以帮助学生学习。"
  Feedback: "太笼统,没有具体说明 AI 如何帮助学习,缺乏说服力。"

Iteration 2:
  Refine:   "AI 通过自适应学习系统,根据每个学生的知识薄弱点
            动态调整题目难度和学习路径,实现真正的因材施教。"
  Feedback: "有具体机制了,但缺少数据支撑或案例。"

Iteration 3:
  Refine:   "以可汗学院的 Khanmigo 为例,AI 辅导系统通过分析学生
            的答题模式识别知识盲区,动态生成针对性练习题。研究表明,
            使用 AI 辅导的学生在数学测试中的进步速度是传统课堂的 2 倍。"
  Feedback: "内容充分,可以输出。"
Self-Refine 的关键设计:
设计要素 说明 反馈维度 明确批评什么——事实准确性?逻辑严密性?表达清晰度?覆盖完整度? 反馈格式 结构化反馈比自由文本更有效——”问题:XX;位置:第 N 段;建议:YY” 终止条件 最大迭代次数(通常 3~5 轮)+ 质量阈值(”反馈中无实质问题”) 迭代记忆 每次修正需要看到之前的版本和反馈,否则会重复犯同样的错误 Self-Refine 与 Reflection 模式的关系: Reflection 是 Self-Refine 在 Agent 场景下的泛化——不仅反思文本输出,还反思行动决策(”我选这个工具对吗?”“这个搜索结果可靠吗?”)。两者的核心机制相同:生成 → 评估 → 修正的循环。
局限: Self-Refine 的效果受限于模型的自我评估能力。如果模型无法识别自己输出中的错误(”不知道自己不知道”),反馈就是无效的,修正也不会改善。对事实性强的任务,应辅以外部验证(如 RAG 检索对照)。
2.3.4 规划策略
推理范式决定”怎么想”,规划策略决定”怎么做”——如何将用户目标拆解为可执行步骤、跟踪执行状态、处理中断和异常。规划是 Agent 从”单次问答”走向”自主完成复杂任务”的关键能力。
任务分解(DAG)
Agent 面对的用户目标往往是模糊且复合的——”帮我做一份 Q3 销售分析报告”。这个目标背后隐含了数据查询、计算、可视化、文字撰写等多个子任务。任务分解就是将模糊目标转化为有依赖关系的可执行步骤图。
DAG(有向无环图)是任务分解的标准数据结构:
目标:Q3 销售分析报告
Step 1: 查询 Q3 销售总额(无依赖,可立即执行)
Step 2: 查询 Q2 销售总额(无依赖,可与 Step 1 并行)
Step 3: 计算环比增长率(依赖 Step 1 + Step 2)
Step 4: 查询各品类销售明细(无依赖,可与 Step 1/2 并行)
Step 5: 按销售额排序 Top 5 品类(依赖 Step 4)
Step 6: 生成可视化图表(依赖 Step 3 + Step 5)
Step 7: 撰写分析报告(依赖 Step 3 + Step 5 + Step 6)
分解的三个核心原则:
原则 说明 反面案例 依赖最小化 能并行的不串行。Step 1、2、4 互不依赖,应并行执行 所有步骤串行 → 总耗时 = 各步耗时之和 粒度适中 每步应是一个”原子能力”能完成的单元。太粗则模型难以一步完成,太细则步骤数爆炸 “查询数据”太粗(实际需要多步查询);”输入 SQL 语句”太细 可验证性 每步输出应可独立验证对错,便于错误定位和重试 中间步骤输出模糊(”分析完成”),无法判断是否正确 动态重规划: 初始 DAG 基于模型对任务的”预判”生成,执行中可能发现新的依赖或更优路径。Agent 应在每步执行后重新评估剩余计划——这被称为 Plan-and-Execute + Replan 模式。
状态管理
当 Agent 同时追踪多个子任务时,需要一个清晰的状态机来回答”执行到哪了”。
标准四态模型:
PENDING ──→ RUNNING ──→ COMPLETED
                │
                └──→ FAILED ──→ PENDING(重试)
状态 含义 转换触发 PENDING 依赖已满足,等待执行 所有前置步骤 COMPLETED → 自动转为 RUNNING RUNNING 正在执行中 调度器分配执行资源 COMPLETED 执行成功,输出已验证 步骤输出通过验证 FAILED 执行失败 工具调用异常 / 输出验证不通过 / 超时 状态管理的工程要点:
- 状态存储: 状态必须持久化在 Agent Loop 之外(数据库 / Redis / 文件),而非仅存在上下文窗口内。上下文窗口可能被压缩或重置,但任务状态不能丢失。
- 状态一致性: 当多个步骤并行执行时,状态更新需要原子操作(如 Redis 的 WATCH + MULTI 或数据库事务),避免两个并行步骤同时将同一个依赖标记为 COMPLETED 导致下游步骤被触发两次。
- 状态可视化: 对用户展示任务进度,对开发者暴露状态机日志(每次状态转换的时间戳和触发原因)。
断点续传
Agent 执行长任务时,中断是常态而非异常——用户关闭了浏览器、网络抖动导致 API 超时、模型服务临时不可用。断点续传确保中断后能从上次状态恢复,而非从头开始。
三个核心机制:
(1)状态序列化:
每次状态变更后,将完整状态快照持久化:
{
  "task_id": "task_20260915_001",
  "current_step": "step_5",
  "steps": {
    "step_1": {"status": "COMPLETED", "output": "Q3 总额 285 万", "completed_at": "..."},
    "step_2": {"status": "COMPLETED", "output": "Q2 总额 320 万", "completed_at": "..."},
    "step_3": {"status": "COMPLETED", "output": "环比 -10.9%", "completed_at": "..."},
    "step_4": {"status": "COMPLETED", "output": "{品类明细 JSON}", "completed_at": "..."},
    "step_5": {"status": "RUNNING", "started_at": "..."},
    "step_6": {"status": "PENDING"},
    "step_7": {"status": "PENDING"}
  }
}
恢复时,COMPLETED 步骤直接复用输出,RUNNING 步骤(如果超时)重新执行,PENDING 步骤按 DAG 依赖继续调度。
(2)幂等性:
每个步骤必须设计为可安全重试——执行 1 次和执行 N 次的效果相同。关键手段:
- 读操作天然幂等(查询销售数据,查 N 次结果相同)
- 写操作需要幂等键(发送邮件时带上
idempotency_key,邮件服务端去重) - 外部 API 调用优先使用
GET,POST类操作需要确认服务端支持幂等。
(3)超时恢复:
超时类型 处理策略 步骤执行超时 标记 FAILED,根据重试策略(最多 3 次,指数退避)重新调度 全局任务超时 用户设定的总时限(如”30 分钟内出报告”),超时后终止剩余步骤,用已完成步骤的中间结果生成部分报告 模型推理超时 降级策略——换用更小更快的模型重试,或跳过该步骤标记为”需人工处理”。
模型路由
不是所有任务都需要最强的模型。模型路由的核心思想是:**根据任务特征,将请求分发到最合适的模型。
路由维度:
维度 路由逻辑 示例 复杂度 简单任务用小模型,复杂任务用大模型 “翻译一句话” → Haiku;”分析合同条款” → Sonnet 延迟要求 实时交互用快模型,后台批处理用慢模型 聊天回复 → 小模型;夜间报告生成 → 大模型 成本预算 按用户等级或任务重要性分配模型配额 免费用户 → 轻量模型;付费用户 → 旗舰模型 领域专长 按任务领域路由到微调过的专用模型 代码生成 → 代码模型;法律文书 → 法律微调模型 路由实现方式:
方式 说明 优缺点 规则路由 预设 if-else 规则(”如果输入含 代码关键词 → 代码模型”)简单可靠,但覆盖不全 分类器路由 训练轻量分类模型判断任务类型,再路由 准确率高,但需要训练数据和维护 LLM 自路由 先用小模型判断任务复杂度,再决定用哪个模型执行 灵活,但增加一次额外推理的延迟和成本 级联路由 先用小模型尝试,输出置信度低时自动升级到大模型 成本最优,但延迟不可预测(可能触发两次推理) 模型降级(Fallback): 路由策略必须包含降级链——当首选模型不可用(超时、限流、报错)时,自动切换到备选模型。降级链通常按”能力强→能力弱”排列,确保可用性优先于最优质量。
2.4 行动:工具与执行
行动层是 Agent 从”说”到”做”的关键跨越。
2.4.1 工具(原子能力)
工具是 Agent 可调用的最小能力单元——一个 API、一个数据库查询、一段代码执行。每个工具都有明确的输入输出定义,Agent 通过标准协议发现和调用它们。
协议:Function Calling / MCP / OpenAPI
当前主流的工具调用协议有三种,它们在抽象层次和标准化程度上各有侧重:
协议 抽象层次 标准化程度 核心思路 Function Calling 模型厂商 各厂自有实现 模型直接输出结构化 JSON 描述要调用的函数和参数 MCP(Model Context Protocol) 跨平台标准 开放协议 Client-Server 架构,统一 Tool/Resource/Prompt 三大原语 **Function Calling **
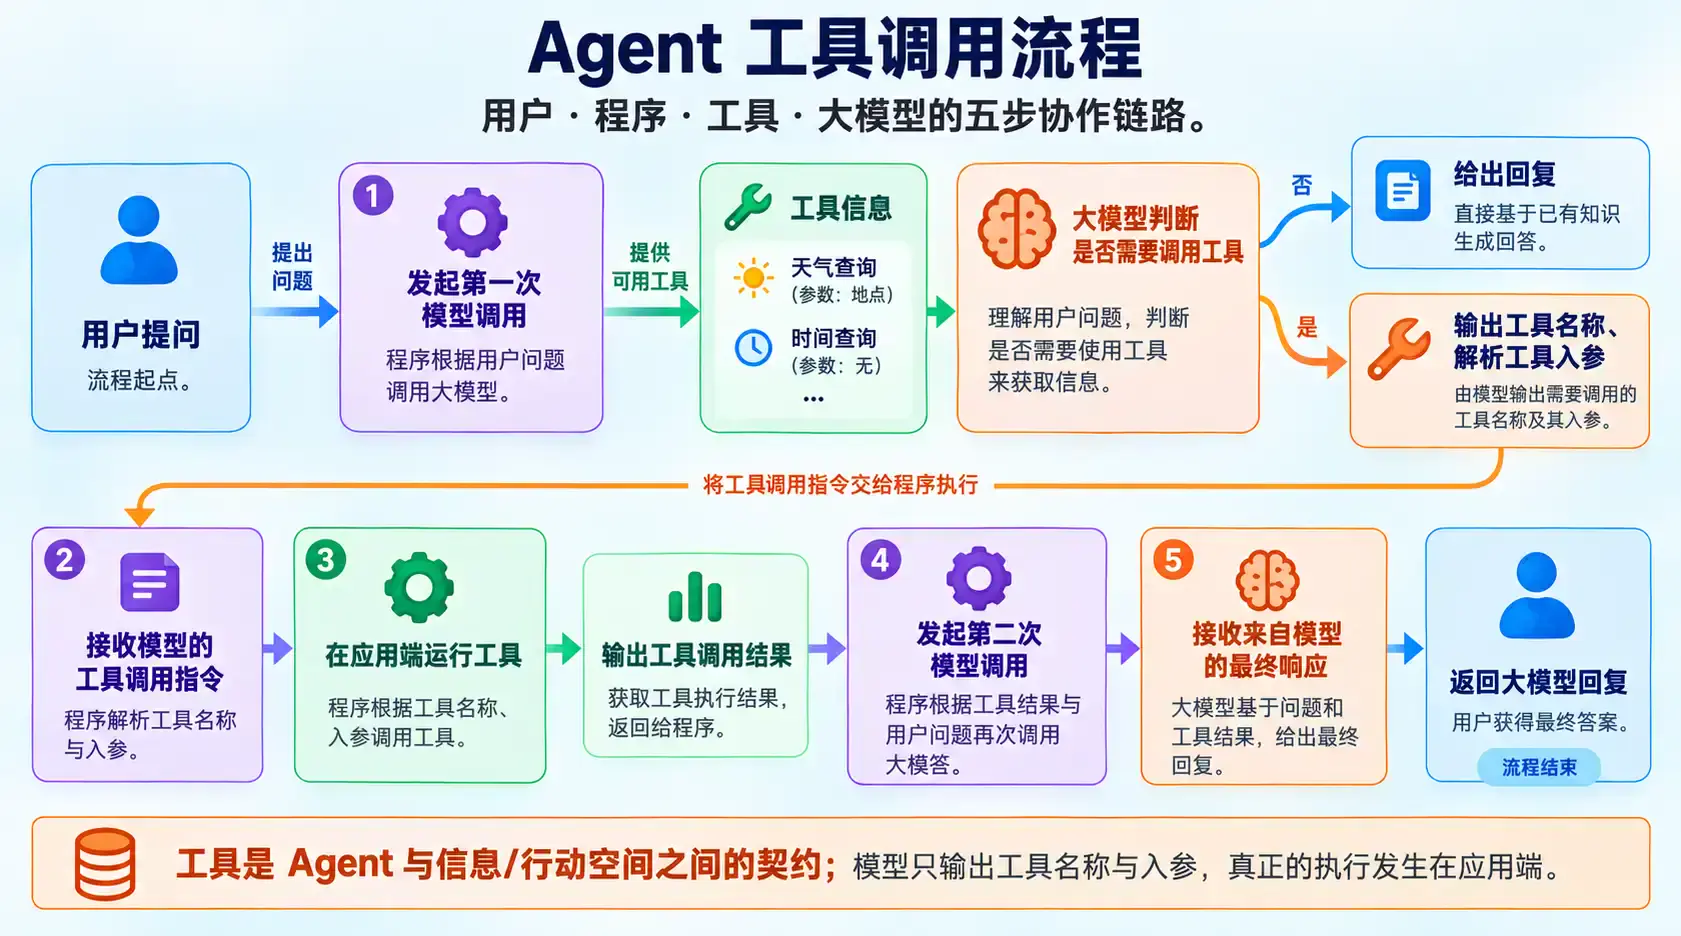
Function Calling 支持两种传入工具信息的方式:
- 方式一:通过 tools 参数传入(
tools参数传入的工具定义会被 tokenize,既计入 token 消耗(计费),也计入上下文窗口,但是有些厂家会针对tools做缓存,后续调用不再计费)。 - 方式二:通过 System Message 传入。
**MCP **
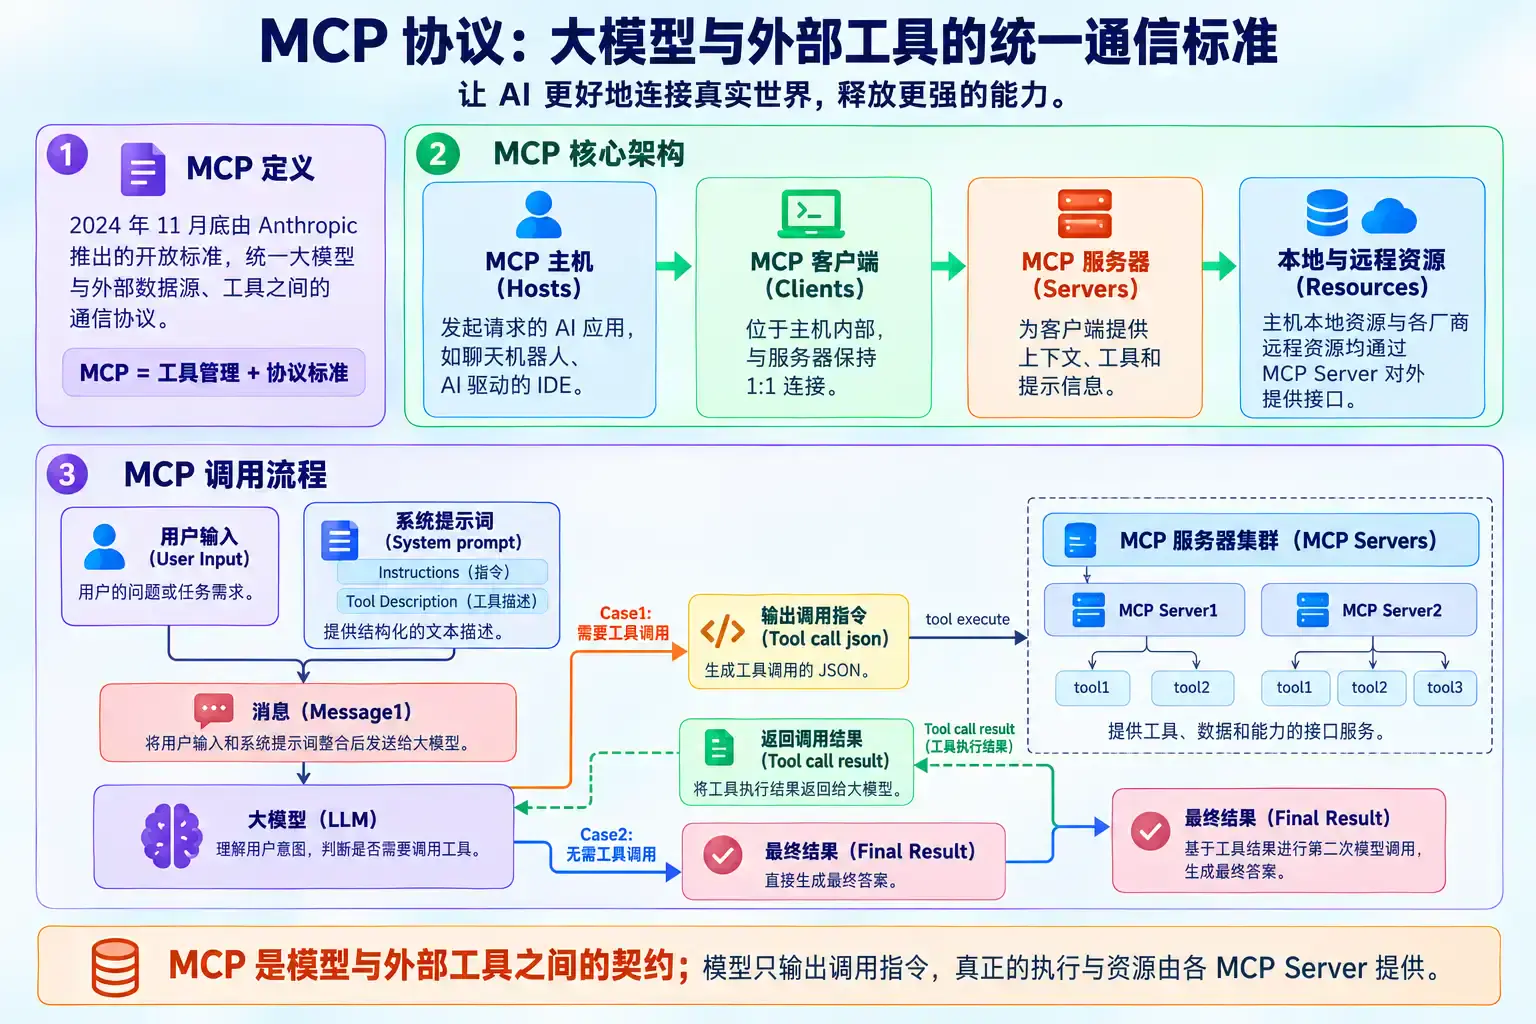
2024年11月底,由 Anthropic 推出的一种开放标准,旨在统一大模型与外部数据源和工具之间的通信协议。准确的说,MCP = 工具管理 + 协议标准,MCP主机的本地资源(包括Function Calling)及远端每个厂商的远程资源通过mcp server 对外提供接口,MCP主机又通过 mcp client 实现互相调用。
MCP遵循客户端 - 服务器架构,包含以下几个核心部分:
- MCP 主机(MCP Hosts):发起请求的 AI 应用程序,比如聊天机器人、AI 驱动的 IDE 等。
- MCP 客户端(MCP Clients):在主机程序内部,与 MCP 服务器保持 1:1 的连接。
- MCP 服务器(MCP Servers):为 MCP 客户端提供上下文、工具和提示信息。
- 本地资源(Local Resources):本地计算机中可供 MCP 服务器安全访问的资源,如文件、数据库、prompt等。
- 远程资源(Remote Resources):MCP 服务器可以连接到的远程资源,如通过 API 提供的数据。
MCP 的三种 Transport 模式:
Transport 管道 原理 stdio 进程的标准输入/输出 Client 启动 Server 子进程,通过 stdin 写 JSON,从 stdout 读 JSON。通过标准输入输出通信,适合本地工具(如 SQLite 查询) SSE HTTP 长连接 + POST客户端发请求走普通的 HTTP POST;服务端响应不走这个 POST 的返回,而是通过一个独立的 GET 长连接( text/event-stream)推送回去;这个 GET 连接建立后不断开,服务端有新消息就写一条data: {...}\n\n,浏览器/客户端收到后触发回调。缺点是需要维护两条连接(POST 发请求 + GET 收响应),部署时还得保证两个连接路由到同一个 Server 实例(有状态),对负载均衡不友好。Streamable HTTP 单个 HTTP 连接双向流 请求和响应都在同一个 HTTP 连接上双向流动,不需要两套机制。客户端发一个 HTTP POST,请求体是 JSON-RPC 消息;服务端不立即返回完整响应,而是用分块传输( Transfer-Encoding: chunked)逐步写回响应。Streamable HTTP是2025 年新规范,被推荐替代 SSE。
管理:动态注册、Schema 标准化、权限控制
工具管理的三个核心挑战:
(1)动态注册:
Agent 不应在启动时写死工具列表,而应在运行时动态发现和注册工具。MCP 的
list_tools机制让 Agent 在连接 Server 后自动获取可用工具清单,无需手动配置。(2)Schema 标准化:
工具描述的质量直接决定模型调用工具的准确率。一个好的工具 Schema 应包含:
工具名称: search_documents
描述: 在知识库中搜索文档,支持关键词和语义搜索
参数:
  - query (string, required): 搜索查询,支持自然语言
  - top_k (integer, optional, default=5): 返回结果数量,范围 1-20
  - filters (object, optional): 过滤条件
    - date_range: 日期范围 {start, end}
    - category: 文档分类
返回: {results: [{title, content, score, url}], total_count: int}
Anthropic 的工具设计原则 :
- 自包含: 工具描述应让模型无需额外上下文就能理解其用途
- 功能重叠最小化: 如果人类工程师无法明确说出该用哪个工具,模型更做不到
- 返回 token 高效: 工具输出应精简,避免将无关数据塞入上下文窗口
(3)权限控制:
工具是 Agent 的”手”,也是最大的安全风险面。权限控制的核心原则是最小权限——Agent 只应拥有完成当前任务所必需的工具权限。
权限策略 说明 示例 静态权限 按 Agent 角色预设工具白名单 客服 Agent 只能查知识库,不能删数据 动态权限 根据任务上下文临时授权 用户确认后,临时开放”发送邮件”工具 人机协同(HITL) 高风险操作需人工确认 删除记录、修改配置、对外发送消息 沙箱隔离 代码执行在隔离环境中运行 Python 沙箱(Pyodide)、容器隔离(Bubblewrap) 落地:工具调用的常见问题与解决方案
环节 常见问题 解决方案 超时处理 API 调用卡住,Agent 无限等待 设置超时上限(通常 30s),超时后返回错误信息给模型,让模型决定重试还是换方案 结果截断 工具返回 10 万 token 的数据库查询结果,撑爆上下文窗口 结果超过阈值(如 2000 token)时自动截断,附截断提示:”结果过长已截断,共 10000 条,显示前 50 条” 错误格式 工具报错返回堆栈信息,模型看不懂 统一错误格式: {error: true, code: "TIMEOUT", message: "查询超时,请缩小查询范围后重试"}重试策略 网络抖动导致偶发失败 保存请求参数快照,指数退避重试(1s → 2s → 4s),最多 3 次,超过后返回最终错误。 幂等校验 重复请求、请求结果不一致 用reqId 和状态管理判断一个请求是否已经在执行或成功完成,防止同一个请求被重复处理。 限流保护 Agent 并发过多 集群级或Pod级llm请求保护器,控制单Pod请求LLM的请求数量,避免LLM流式连接或LLM变慢时占满连接池、内存和Reactor资源。 结果缓存 短时间内多次以相同参数请求工具,重复消耗资源和成本 以 {工具名, 参数hash}为 key,命中缓存直接返回,TTL 根据数据时效性设定(实时数据 5s,静态数据 1h)结果审计 事后无法追溯 Agent 调了什么工具、传了什么参数、返回了什么结果 每次工具调用记录完整日志(工具名、参数、返回值摘要、时间戳、耗时、调用方),持久化存储,支持按任务/用户/时间维度查询 Token 计费 tools 定义和工具返回结果都消耗 token,成本不可见且难以优化 按工具维度统计 token 消耗(工具定义 token + 返回结果 token),输出成本归因报告,识别”高消耗低价值”的工具调用
2.4.2 技能(复合能力)
工具是原子操作,技能是复合能力,通过渐进式披露工作,包含指令、脚本和资源的文件夹,等Agent真的决定调用某个 skill 时,再把这些重内容展开。
工具(原子能力) 技能(复合能力) 单次 API 调用能完成的 需要多次工具调用编排的 无业务逻辑,纯数据透传 包含业务规则和决策逻辑 通用、跨场景复用 面向特定业务场景 不关心”为什么调用”,只管”怎么执行” 定义”什么时候调用、按什么顺序、失败怎么办” 设计:Skill 设计的核心原则
原则 说明 Skill 功能:单一职责 一个 Skill 只做一件完整的事,边界清晰。 SKill 描述:自包含 Skill 描述应让模型无需外部上下文就能判断是否使用。 Skill 内容:最小高信号 Skill 内容只包含模型决策和执行必需的信息。 多个 Skill:可组合 Skill 之间可以联动,如Skill A 的输出是 Skill B 的输入。 Skill 容错:可失败 明确定义失败模式:什么情况重试、什么情况降级、什么情况终止 编排:按顺序/条件组合成可复用模块
技能编排有三种基本模式:
模式 结构 适用场景 示例 顺序链 A → B → C 步骤有严格先后依赖 查数据 → 做分析 → 出报告 条件分支 A → 条件判断 → B 或 C 根据中间结果选择路径 查询成功 → 生成报告;查询失败 → 通知用户 并行扇出 A 同时触发 B、C、D,结果汇聚 多步互不依赖,可并行加速 同时查销售/库存/用户三个数据源,汇总分析 发现:基于语义的技能检索与推荐
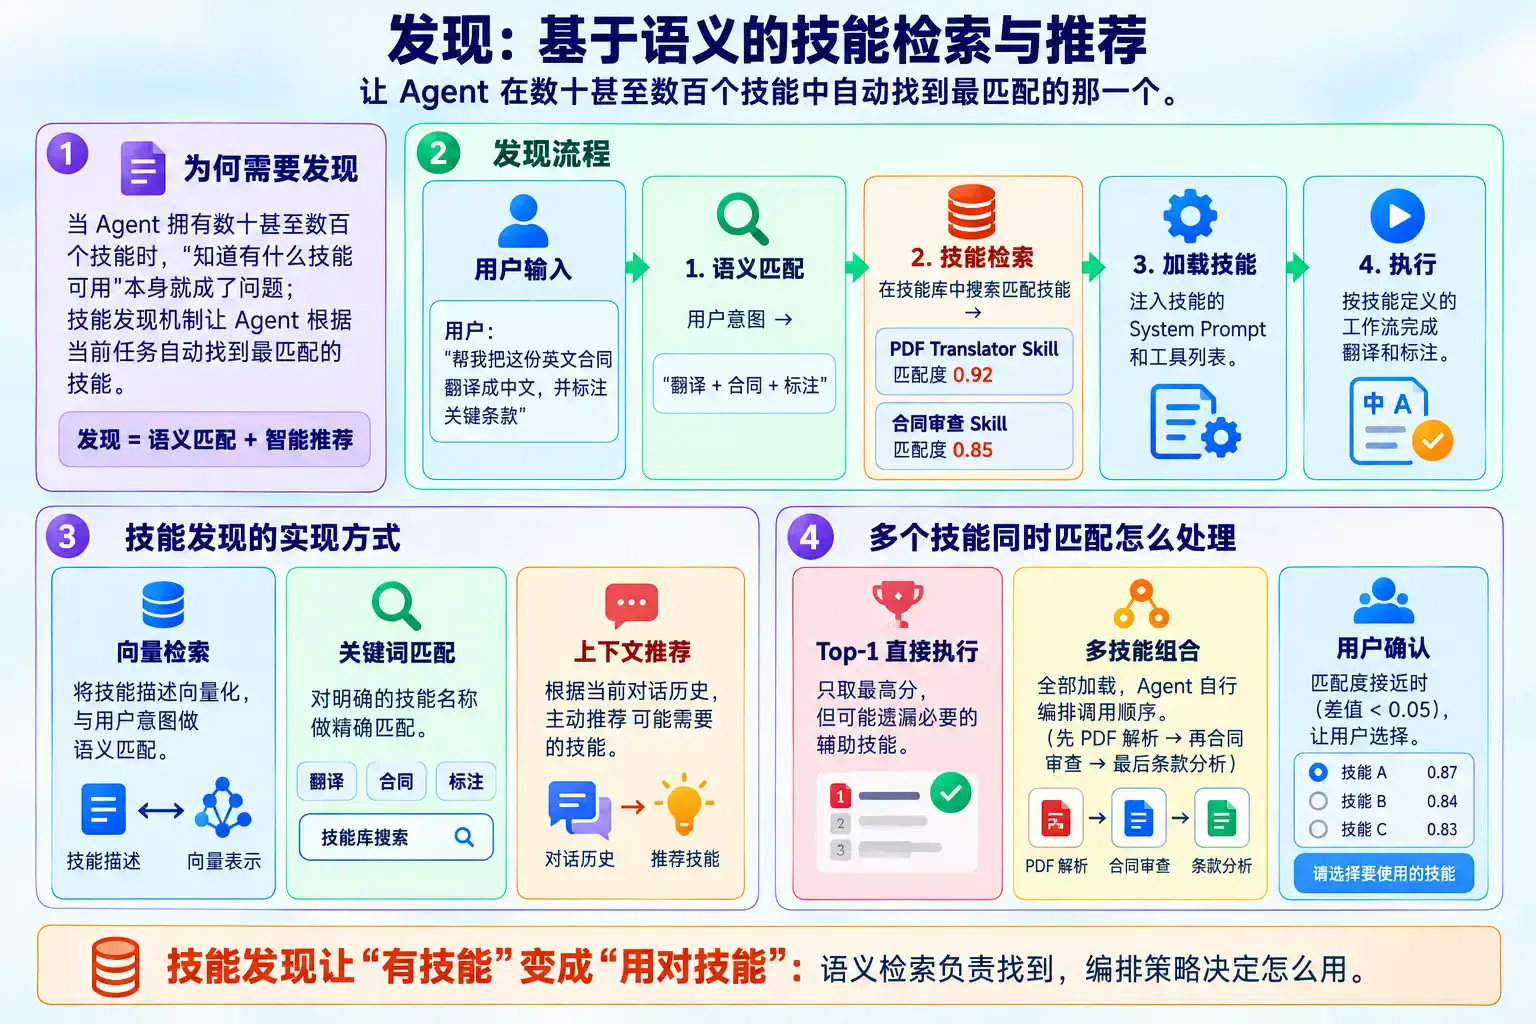
2.5 记忆:贯穿全循环的跨会话上下文
在前面的
1.2章节 AI系统演进脉络提到过,LLM的模型参数只读,本身是无状态的。记忆承担了维护跨会话上下文的职责,而它面临的最大挑战就是上下文窗口限制。如何通过合理的组织方式实现高效的记忆读写,是Agent系统需要解决的核心问题。2.5.1 写记忆
写记忆的核心挑战在于三个部分:内容管理(记什么)、生命周期管理(记多久)、存储方式管理(放哪里)。
内容管理
记忆的分类没有统一规范,这里按生命周期和作用域将其分为五类:
类型 生命周期 作用域 存储内容 示例 任务记忆 当前任务/会话 当前任务的所有步骤 任务目标、已完成的子任务、中间产物路径 “已生成 Q3 报告草稿,待补充图表” 情景记忆 跨任务/跨会话 用户级 过往对话摘要、历史任务轨迹、关键事件 “上周五和用户讨论了 Q3 预算方案,用户倾向于方案 B” 短期记忆 最近 N 轮对话 当前会话 对话历史原文或摘要 用户 3 轮前说”图表用蓝色主题” 长期记忆 跨会话持久化 全局 用户偏好、历史行为、领域知识 “用户偏好:报告一律用中文,图表用蓝色” 五类记忆的关系:
- 工作记忆是 Agent 执行单步操作时的”瞬时 scratchpad”,容量最小、流转最快。
- 任务记忆把多个步骤串成完整任务的”进度条”,任务完成后大部分被丢弃,只有关键信息进入下一层。
- 情景记忆是跨任务的”经历沉淀”——记录发生过什么、做过什么决策、结果如何。它与任务记忆的区别在于:任务记忆只关心”当前这个任务”,情景记忆关心”历史上做过哪些任务”。情景记忆是任务记忆经过筛选和摘要后的跨任务版本。
- 短期记忆是当前会话的”上下文缓存”,存放尚未确认是否值得长期保留的信息。它与情景记忆的区别在于:短期记忆是会话级的、临时的,情景记忆是用户级的、持久化的。
- 长期记忆是从情景记忆和短期记忆中反复确认后沉淀的”持久知识”。
生命周期管理
记忆不是一次性写入的,而是从会话上下文中逐层沉淀下来的。整个过程分三个阶段:会话进行中(工作记忆 → 任务记忆 → 情景记忆 → 短期记忆)、会话结束后(LLM 异步提取)、写入时(重要性分流 + 冲突处理)。
会话进行中

会话结束时
LLM 对短期记忆和情景记忆做一次异步的深度提取,输出结构化的候选事实条目。这一步不是简单的文本压缩,而是把对话拆解为可独立检索、可独立更新的”事实卡片”——每条事实包含内容、类型(偏好/知识/决策)、置信度、来源(用户声明/模型推断)。异步处理不阻塞用户,代价是记忆有数分钟的滞后。
写入时
候选事实进入长期存储前,需与已有记忆做语义匹配,根据相似度和内容关系输出四种操作(Mem0 的写入模型):
操作 判定条件 处理方式 示例 ADD 相似度 < 0.5,全新信息 直接写入 用户首次提到”喜欢蓝色主题” UPDATE 相似度 > 0.5,相关但不矛盾 合并新旧信息 “偏好蓝色” + “偏好深蓝色” → 合并 REPLACE 相似度 > 0.5,内容矛盾 旧记忆标记失效,新记忆写入 “在北京工作” → “搬到杭州了” NOOP 相似度 > 0.85,几乎相同 不写入 用户再次确认已知偏好 冲突决策优先级:显式声明 > 多次确认 > 单次提及。所有 REPLACE 操作保留旧记忆的历史版本(带失效时间戳),支持时序查询——既能回答”用户现在在哪?”也能回答”用户去年在哪?”。两条高置信度记忆矛盾且无法自动判定时,主动询问用户。
从工程角度看,记忆系统的核心挑战不是”记住”,而是”跟上变化”——用户会搬家、会换工作、会改偏好。一个只增不删的记忆系统,最终会变成过期信息的垃圾场。生命周期管理的本质,就是把记忆从”静态存储”升级为”动态治理”。
存储方式管理
五类记忆的生命周期不同,存储选型也不同:
记忆类型 存储方式 典型方案 关键设计 工作记忆 上下文窗口内,不持久化 当前请求的 message list 容量受窗口限制,需配合上下文压缩防止溢出 任务记忆 会话级存储,会话结束清理 Redis / 内存 KV(key: session_id) 写入频繁、读取频繁,延迟敏感,不适合落盘 情景记忆 持久化,按用户 + 时间索引 PostgreSQL / SQLite + 全文索引 需要按时间范围查询(”最近 30 天的任务记录”),支持关键词搜索 短期记忆 持久化,带 TTL 自动过期 SQLite / PostgreSQL + TTL 索引 按时间窗口自动清理(”保留最近 7 天的对话摘要”) 长期记忆 持久化,向量化 + 结构化双写 向量数据库(语义检索)+ 结构化存储(精确查询) 双写保证:语义相似用向量查,精确匹配用结构化字段查 情景记忆和短期记忆的存储选型容易混淆,核心区别在于:情景记忆按用户维度组织、无 TTL(”用户做过什么”是永久档案),短期记忆按会话维度组织、有 TTL(”最近聊了什么”过期即清理)。
长期记忆的双写策略是最关键的工程决策。向量数据库(Milvus、Pinecone、pgvector)解决”找相似”——用户问”我之前说过喜欢什么颜色?”,语义检索能召回相关偏好。结构化存储解决”精确查”——按
user_id、type、created_at过滤,避免把 A 用户的记忆召回给 B 用户。两者互补,单独依赖任一方都会出问题:纯向量检索缺乏权限隔离,纯结构化检索无法处理模糊语义。
2.5.2 读记忆
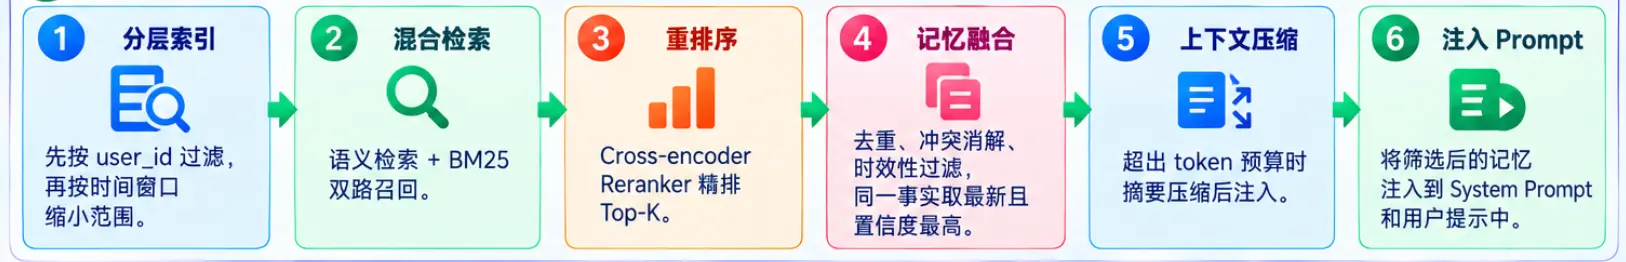
3. 协作范式:多 Agent 系统 (MAS)
3.1 设计模式
- ReAct, Plan-and-Execute, Reflection, Multi-Agent Debate
3.2 协作架构
- 角色分工:Planner, Executor, Critic, Memory Manager
- 通信机制:消息路由 (Pub/Sub), 共识机制, 冲突解决
- 人机协同 (HITL):人工确认节点, 偏好反馈, 主动求助
4. 基础设施与环境
4.1 运行环境
- 沙箱技术:代码沙箱, 浏览器环境, OS 模拟器
- 资源隔离:容器化部署, 权限最小化原则
4.2 标准化与互操作性
- 协议生态:MCP (Model Context Protocol), A2A (Agent-to-Agent)
- 描述标准:语义化 API 描述, 技能元数据规范
5. 实现形态:Code Harness 与集成
5.1 主流 Harness 对比
- DeepSeek, Claude Code, Codex/Copilot, OpenClaw
5.2 典型应用场景
- 研发效能 (查数/写码/建单), 数据分析, 智能客服
6. 工程治理:落地关键问题
6.1 可观测性 (Observability)
- 链路追踪 (Trace ID), Token 监控, 推理过程可视化
6.2 安全与对齐 (Security)
- 提示注入防御, 输出审计, 数据隔离 (RBAC/ABAC), 越狱检测
6.3 性能与成本 (Performance)
- 缓存策略 (语义/结果), 并行执行, 模型降级, 端侧推理
6.4 评估与进化 (Evaluation & Evolution)
- 自动化基准:AgentBench, GAIA, SWE-bench
- 数据飞轮:从执行轨迹提取 SFT/RLHF 数据
- 线上监控:A/B 测试, 成功率/重试率, 用户反馈闭环
Agent 评测
https://tech.meituan.com/2026/08/07/Agent-Evaluation.html
因此,Agent 评测至少需要覆盖四层内容:
- 结果层:任务是否完成,输出是否可用
- 过程层:规划是否合理,步骤是否稳定
- 效率层:耗时、Token、工具调用次数是否可接受
- 风险层(安全层):是否越权、是否误操作、是否存在安全隐患
RSI
https://zhuanlan.zhihu.com/p/2065227313973825752